조정우
- Markdown
- SW 컴플라이언스 및 정책연구
- 오픈소스 라이선스 비교
- 오픈소스 라이선스/취약점 관리 참고자료
- 오픈SW 라이선스 검사도구
- 오픈소스 SW라이선스 내부교육 자료
- AI 데이터셋과 오픈소스 컴플라이언스 관련 사례
- 전자정부 프레임워크 5.0 (Beta) 표준사양서
- 국가AI전략위 문서작성 체계 혁신화
- 2026년 국가 AI데이터센터 고도화사업 — 이용자 정기모집 신청 가이드
- Practical Mermaid v11 실무 다이어그램 쿡북 테스트
- 결함보고서
- Claude 4.7 아키텍처의 축자주의적 전환과 에이전트 운영 결함 분석
- VS Code Remote-SSH 접속 시 원격 서버에서 전체 개발환경이 실행되는 문제
- Kubernetes 환경 JVM OOM Kill 원인 분석 — UseContainerSupport와 cgroup 메모리 인식 문제
- RFC 20 — ASCII: 네트워크 문자 교환의 기초
- PlantUML
- Cookbook
Markdown
지식 데이터 문서 포맷에 따라 AI 파이프라인 구축시 미치는 비용 분석과 전략
How Machine-Readable Document Formats Affect AI Pipeline Performance and Cost
연구 배경
2026년 3월 5일, 국가인공지능전략위원회는 정책 문서를 마크다운(.md) 형식으로 전환하여 작성·관리·공개한다고 발표하였다 1.이 정책적 전환은 HWP 중심의 시각적 편집 문서가 AI 학습·활용에 적합하지 않다는 문제의식에서 출발한다.
본 연구노트는 이 전환의 기술적 근거를 벤치마크 문헌 분석을 통해 수립하고, AI 시대의 문서 데이터 프로세싱 전략에 필요한 실증 기반(evidence base)을 구축한다.
목차
- 왜 문서 포맷이 AI 성능을 결정하는가
- 인용 논문의 저명성 및 신뢰도
- 비정형 문서의 비용: OCR이 만드는 성능 천장
- 구조화된 포맷의 이점: 검색 정확도와 추론 품질
- 포맷이 결정하는 토큰 비용: 기업 규모의 체감치
- LLM이 인식하는 포맷의 스펙트럼
- 종합: 확인된 사실과 미해결 과제
- 다음 연구를 위한 방향
- 참고문헌
1. 왜 문서 포맷이 AI 성능을 결정하는가
AI 시스템, 특히 검색 증강 생성(RAG) 파이프라인에서 외부 문서는 핵심 입력 자원이다. 같은 정보라도 어떤 형태로 투입하느냐에 따라 검색 정확도, 추론 품질, 토큰 비용이 극적으로 달라진다.
%%{init: {'theme': 'neutral', 'themeVariables': {'fontSize': '14px', 'fontFamily': 'IBM Plex Sans, Pretendard, sans-serif'}}}%%
flowchart LR
    subgraph legacy["비정형 문서 파이프라인"]
        direction TB
        A["PDF / HWP / 스캔본"] --> B["OCR 텍스트 추출"]
        B --> C["포맷팅 노이즈 발생"]
        C --> D["글자수 기반 기계적 Chunking"]
        D --> E["검색 실패 · 환각 · 토큰 낭비"]
    end

    subgraph modern["기계가독형 문서 파이프라인"]
        direction TB
        F["Markdown / HTML"] --> G["태그 기반 의미 파싱"]
        G --> H["계층 구조 보존"]
        H --> I["의미 기반 Chunking"]
        I --> J["고정밀 검색 · 정확한 추론 · 토큰 절약"]
    end

    E -. "성능·비용 격차" .-> J

    style legacy fill:none,stroke:#b0b0b0,stroke-width:1px
    style modern fill:none,stroke:#2563eb,stroke-width:2px
    style E color:#b91c1c,stroke:#b91c1c
    style J color:#15803d,stroke:#15803d
그림 1. 비정형 문서와 기계가독형 문서의 RAG 파이프라인 구조 비교
국가AI전략위원회가 밝힌 전환 이유: "기존 한글 문서는 글꼴, 자간, 기호표 등 다양한 편집 요소가 적용돼 AI가 문장과 문단 구조를 정확히 인식하는 데 어려움이 있다" 1.
2. 인용 논문의 저명성 및 신뢰도
선정 시 특정 벤더의 자사 제품 홍보 성격이 강한 논문은 배제하였으며, 구조화 포맷의 효과를 일관되게 지지하는 독립적 연구만을 선별하였다.
| 논문 | 게재처 | 게재처 위상 | 저자·소속 | 학술적 기여 |
|---|---|---|---|---|
| OHR-Bench 2 | ICCV 2025 | CV Top-3, h5-index 291, 수락률 27% | 북경대 Wentao Zhang 그룹 | OCR→RAG 연쇄 영향 최초 전용 벤치마크 |
| HtmlRAG 3 | WWW 2025 | 웹/IR 최고 학회, CORE A* | 중국인민대 Ji-Rong Wen (IR 저명) | HTML RAG 활용 최초 연구, GH 460+ stars |
| DocLLM 4 | ACL 2024 | NLP Top-1, h5-index 279 | JPMorgan AI Research | 레이아웃 인식 LLM 최초 제안, 인용 200+ |
| LAD-RAG 5 | arXiv 2025 | 프리프린트 | USC 외 다기관 | 레이아웃 인식 동적 RAG, 4개 벤치마크 검증 |
| UniDoc-Bench 6 | arXiv 2025 | 프리프린트 | Salesforce AI Research | MM-RAG 통합 벤치마크 최초, 70k PDF 규모 |
| KL3M 7 | arXiv 2025 | 프리프린트 | ALEA Institute (Stanford/MSU) | 법률/금융 토크나이저 최초 공개, Apache 2.0 |
| BigDocs 8 | ICLR 2025 | ML Top-3, h5-index 304 | Mila (Bengio 연구소), 43명 공저 | 7.5M 문서 오픈셋, Yoshua Bengio 공저 |
| Prompt Format 9 | arXiv 2024 | 프리프린트 | CVS Health 독립 연구팀 | 포맷별 LLM 성능 비교 최초 체계적 실험 |
| MDEval 10 | arXiv 2025 | 프리프린트 | 화중과기대(HUST) | LLM Markdown 인식 평가 최초 전용 벤치마크 |
| StructEval 11 | arXiv 2025 | 프리프린트 | Waterloo대 Wenhu Chen 그룹 | 18개 포맷·44개 태스크 구조적 출력 벤치마크 |
| PDFbench 12 | 독립 벤치마크 2025 | Applied AI (독립 리서치) | 800+ 실제 업무 문서, 17개 파서 비교 | 텍스트 정확도와 구조 복원율을 분리 측정한 최초 대규모 벤치마크 |
| Improving Agents 1314 | 독립 벤치마크 2025 | Improving Agents (AI 에이전트 최적화 전문) | 11개 포맷, 1,000건 테이블 + 1,000건 중첩 데이터 | LLM 입력 포맷별 이해 정확도·토큰 효율 최초 대규모 비교 |
| Skyvern 15 | 실무 보고 2024 | Skyvern (브라우저 자동화 스타트업) | 프로덕션 환경 HTML vs JSON 전환 | 토큰 11% 절감 + 성공률 3.9% 향상 실무 검증 |
표 1. 인용 논문 저명성 요약. h5-index는 Google Scholar Metrics 2025 기준.
3. 비정형 문서의 비용: OCR이 만드는 성능 천장
3.1 OHR-Bench — 모든 OCR은 실패한다
OHR-Bench (ICCV 2025) 2는 OCR이 RAG 시스템에 미치는 연쇄적 영향을 측정한 최초의 전용 벤치마크이다.
실험 규모: 7개 도메인 / 8,561개 문서 이미지 / 8,498개 QA 쌍
%%{init: {'theme': 'neutral', 'themeVariables': {'fontSize': '13px', 'fontFamily': 'IBM Plex Sans, Pretendard, sans-serif'}}}%%
xychart-beta
    title "OHR-Bench: Ground Truth 대비 F1 하락폭 (%)"
    x-axis ["Qwen2.5-VL-72B", "MinerU", "GOT-OCR", "Pipeline OCR"]
    y-axis "F1 Score Loss (%)" 0 --> 25
    bar [14, 18, 20, 22]
그림 2. OCR 솔루션별 F1 하락폭. 최우수 솔루션에서도 14% 하락 관찰.
| 핵심 발견 | 수치 | 의미 |
|---|---|---|
| 최우수 OCR 전체 F1 하락 | -14% | 현존 최고 기술로도 원본 대비 14% 손실 |
| EM@1 하락 | -1.9 | 정확 매칭 기준 유의미 저하 |
| F1@1 하락 | -2.93 | 검색·생성 단계 모두에서 누적 |
연구진 결론: "평가된 모든 OCR 솔루션이 성능 저하를 보였으며, 고품질 RAG 지식베이스 구축에 적합한 솔루션은 존재하지 않았다."
해석: 비정형 문서→텍스트 추출→RAG 투입 파이프라인은, 어떤 OCR을 사용하든 **구조적 성능 상한선(ceiling)**을 가진다. 문서를 처음부터 기계가독형으로 생산하는 것만이 이 상한선 자체를 제거할 수 있다.
4. 구조화된 포맷의 이점: 검색 정확도와 추론 품질
4.1 HtmlRAG — 구조 보존이 RAG 품질을 높인다
HtmlRAG (WWW 2025) 3는 평문 대신 구조가 보존된 HTML을 RAG 입력으로 사용할 경우의 성능 우위를 6개 QA 데이터셋에서 검증하였다.
%%{init: {'theme': 'neutral', 'themeVariables': {'fontSize': '13px', 'fontFamily': 'IBM Plex Sans, Pretendard, sans-serif'}}}%%
flowchart TD
    A["웹 문서 원본 HTML"] --> B{"RAG 투입 방식"}
    B -->|"평문 추출"| C["헤딩·표 구조 소실"]
    B -->|"HTML 보존 + Pruning"| D["구조적 의미 유지"]
    C --> E["6/6 QA 데이터셋에서 열위"]
    D --> F["6/6 QA 데이터셋에서 일관 우위"]

    style C stroke:#b91c1c,stroke-dasharray:5 5
    style D stroke:#2563eb,stroke-width:2px
    style E color:#b91c1c
    style F color:#15803d,font-weight:bold
그림 3. HtmlRAG의 실험 구조. 구조 보존 경로가 6개 데이터셋 전체에서 우위.
마크다운의 #, ##, |표| 구문은 HTML의 <h1>, <h2>, <table>을 경량화된 형태로 보존한다. HtmlRAG의 핵심 발견 — "구조적 의미가 보존될수록 RAG 품질이 높아진다" — 은 마크다운의 가치를 구조적 관점에서 뒷받침한다.
4.2 DocLLM — 레이아웃 정보의 정량적 가치
DocLLM (ACL 2024) 4은 bounding box 정보만으로 문서의 공간 구조를 파악하는 disentangled spatial attention 메커니즘을 도입하였다.
| 실험 설정 | 결과 | 비고 |
|---|---|---|
| 16개 데이터셋 SotA 달성 | 14/16 (87.5%) | 이미지 인코더 없이 달성 |
| 미확인 데이터셋 일반화 | 4/5 (80%) | STDD 설정 |
| Llama2-7B 대비 성능 향상 | +15% ~ +61% | 미확인 4개 데이터셋 기준 |
표 3. DocLLM 핵심 실험 결과.
레이아웃 정보가 보존되면 LLM의 문서 이해 성능이 15~61% 향상된다. 마크다운의 제목 계층, 들여쓰기, 표 구문은 이 레이아웃 정보의 핵심을 텍스트 수준에서 보존하는 수단이다.
4.3 LAD-RAG — 구조 메타데이터가 검색을 결정한다
LAD-RAG (arXiv 2025) 5는 문서의 레이아웃 구조와 페이지 간 의존성을 심볼릭 그래프로 구축하여 동적으로 검색하는 프레임워크이다. 4개 벤치마크(MMLongBench-Doc, LongDocURL, DUDE, MP-DocVQA)에서 평가하였다.
| 측정 항목 | 수치 | 조건 |
|---|---|---|
| 평균 Perfect Recall | 90% 이상 | top-k 튜닝 없음 |
| 베이스라인 대비 Recall 향상 | 최대 +20% | 동일 노이즈 수준 비교 |
표 4. LAD-RAG 핵심 실험 결과.
구조적 메타데이터(섹션 헤더, 페이지 간 관계, 요소 유형)를 명시적으로 인덱싱하면 고정 top-k 방식보다 현저히 높은 recall을 달성한다. 마크다운의 #, ##, --- 등이 이 메타데이터를 자연스럽게 표현하며, 평문에서는 불가능하다.
4.4 UniDoc-Bench — 텍스트만으로는 부족하다
UniDoc-Bench (arXiv 2025, Salesforce AI Research) 6은 70k PDF 페이지, 1,600개 멀티모달 QA 쌍으로 4가지 RAG 패러다임을 동일 조건에서 비교하였다.
| 순위 | RAG 패러다임 | Completeness | 비고 |
|---|---|---|---|
| 1위 | 텍스트-이미지 융합 (text-image fusion) | 68.4% | 별도 텍스트·이미지 검색기를 결합 |
| 2위 | 텍스트 전용 (text-only) | 65.3% | 텍스트만으로도 융합의 95% 수준 |
| 3위 | 멀티모달 공동 임베딩 (joint retrieval) | 64.1% | 단일 임베딩으로 두 모달리티를 처리 |
| 4위 | 이미지 전용 (image-only) | 54.5% | 텍스트 대비 -10.8%p, 최하위 |
표 5. UniDoc-Bench 4가지 RAG 패러다임의 Completeness 점수(1,600 QA, GPT-4.1 기반 평가). top-k=10.
텍스트도 이미지도 단독으로는 불충분하다. 그러나 텍스트가 잘 구조화되어 있을수록 fusion의 품질도 높아진다. 마크다운은 이 "잘 구조화된 텍스트"를 가장 경량으로 생산하는 수단이다.
5. 포맷이 결정하는 토큰 비용: 기업 규모의 체감치
5.1 기업 서비스 규모에서의 비용 환산
LLM의 모든 연산은 "토큰" 단위로 이루어진다. 동일한 정보를 더 적은 토큰으로 전달할수록 GPU 사용 시간, 전기 비용, 응답 지연이 줄어든다.
아래 표는 KL3M 7의 9-17% 문서 전체 토큰 절감 결과를 기반으로, 실제 서비스 기업의 규모에서 비용을 환산한 것이다. 15% 절감(중간값)을 적용하였다.
| 규모 | 비구조화 평문 | 구조화 마크다운 (15% 절감) | 절감 효과 |
|---|---|---|---|
| 일 10만 건 · 문서당 5,000토큰 | |||
| — 일간 토큰 수 | 5억 | 4.25억 | -7,500만 토큰/일 |
| — 일간 API 비용 ($10/M) | $5,000 | $4,250 | $750/일 |
| — 연간 API 비용 (250 영업일) | $1,250,000 | $1,062,500 | 연 $187,500 절감 |
| — 연간 A100 GPU 시간 | 약 2,083시간 | 약 1,770시간 | 313시간 절감 |
| — 연간 전력 (A100 300W) | 625 kWh | 531 kWh | 94 kWh 절감 |
| 일 100만 건 (대형 플랫폼) | |||
| — 연간 API 비용 | $12,500,000 | $10,625,000 | 연 $1,875,000 절감 |
| — 연간 A100 GPU 시간 | 약 20,833시간 | 약 17,708시간 | 3,125시간 절감 |
표 6. 기업 서비스 규모에서의 토큰 비용 환산. 15% 절감 기준(KL3M 중간값).
참고: 도메인 특화 용어가 많은 경우(법률: 최대 83%, 금융: 39%) 절감폭은 이보다 훨씬 크다. 또한 토큰 절감은 API 비용뿐 아니라 Context Window 활용 효율, 응답 지연(latency), 배치 처리량에도 복합적으로 기여한다.
5.2 KL3M Tokenizers — 도메인 특화 토크나이저의 효과
KL3M Tokenizers (arXiv 2025, ALEA Institute) 7는 약 1.5T 토큰의 법률/금융 텍스트 코퍼스에서 훈련된 도메인 특화 BPE 토크나이저이다.
| 적용 범위 | GPT-4o 및 Llama3 대비 절감 |
|---|---|
| 법률/금융/행정 문서 전체 | 9-17% |
| 법률 전문 용어 (예: "Fed. R. Civ. P. 56(a)") | 최대 83% |
| 금융 전문 용어 (예: "EBITDA") | 39% |
표 7. KL3M 토크나이저의 토큰 절감 효과. 83%는 용어 단위 수치, 문서 전체는 9-17%.
5.3 BigDocs-Bench — 구조화 데이터의 훈련 가치
BigDocs (ICLR 2025, Mila / Yoshua Bengio 공저) 8는 7.5M 멀티모달 문서와 329k 훈련 샘플을 포함하는 대규모 오픈 데이터셋이다.
| 측정 항목 | 수치 |
|---|---|
| BigDocs fine-tune 모델 vs GPT-4o (구조화 출력 태스크) | +25.8% |
| 인간 평가 선호도 vs GPT-4o | 63% |
| 인간 평가 선호도 vs Phi3.5 Instruct | 88% |
표 8. BigDocs-Bench 결과. 구조화 문서 훈련의 가치를 입증.
사내 문서를 마크다운으로 축적하면 향후 모델 fine-tuning 데이터로도 활용 가능하다.
6. 왜 Markdown인가 — 포맷 선택의 다차원 비교
6.1 측정 차원의 분리
포맷 비교에서 흔히 빠지는 오류는, LLM이 특정 포맷을 "생성하는 능력"과 특정 포맷을 "입력받아 이해하는 능력"을 혼동하는 것이다. JSON은 LLM이 생성할 때 90%+ 정확도를 보이지만(StructEval 11), 이것이 "JSON으로 데이터를 넣으면 AI가 잘 이해한다"를 의미하지는 않는다. 실제로는 정반대 결과가 나온다. 이 차이를 명확히 하기 위해, 포맷 성능을 3개 차원으로 분리한다.
6.2 차원 A — LLM의 포맷 생성 정확도
StructEval 11에서 측정한, LLM이 자연어로부터 각 포맷을 정확하게 생성하는 능력이다. JSON, HTML, CSV, Markdown 모두 90% 이상으로 이 차원에서는 4개 포맷 간 유의미한 차이가 없다.
| 포맷 | 생성 정확도 |
|---|---|
| JSON / HTML / CSV / Markdown | 모두 90% 이상 (AI 친화 포맷 군) |
표 9-A. StructEval 기준 LLM 포맷 생성 정확도. 4종 모두 90%+로 차이 없음.
6.3 차원 B — 포맷을 입력으로 받았을 때의 이해·추론 정확도
이 차원에서 Markdown과 JSON의 차이가 벌어진다. 동일 데이터를 서로 다른 포맷으로 LLM에 입력했을 때의 정확도이다.
추론 태스크 (Prompt Format 9, GPT-4 MMLU):
| 포맷 | 정확도 |
|---|---|
| Markdown | 81.2% |
| Plain Text | 77.0% |
| YAML | 75.5% |
| JSON | 73.9% |
테이블 이해 태스크 (Improving Agents 13, 11개 포맷, 1,000건):
| 포맷 | 정확도 |
|---|---|
| Markdown-KV | 60.7% |
| JSON | 50.8% |
| CSV | 44.7% |
중첩 데이터 이해 (Improving Agents 14, 1,000건 질의, GPT-5 Nano·Gemini):
| 포맷 | 결과 |
|---|---|
| YAML | 1위 |
| Markdown | 2위 (YAML과 근접) |
| JSON | 하위권 (GPT-5 Nano·Gemini에서 성능 저조) |
| XML | 최하위 (Markdown 대비 80% 더 많은 토큰 사용하면서도 최저 정확도) |
표 9-B. 입력 포맷별 LLM 이해·추론 정확도. Markdown이 일관되게 상위권이며, JSON은 "생성은 잘 하지만 이해는 떨어지는" 역전 현상을 보인다.
6.4 차원 C — 토큰 효율성
동일 데이터를 각 포맷으로 표현했을 때의 토큰 소비량이다.
| 포맷 | JSON 대비 토큰 비율 | 출처 |
|---|---|---|
| Markdown | -34~38% | Improving Agents (중첩) 14 |
| YAML | Markdown보다 약 10% 많음 | Improving Agents (중첩) 14 |
| JSON | 기준 (100%) | — |
| XML | +80% (Markdown 대비) | Improving Agents (중첩) 14 |
표 9-C. 동일 데이터의 포맷별 토큰 소비량.
6.5 3개 차원 종합: 왜 Markdown이 최적인가
| 차원 | JSON | HTML | CSV | Markdown |
|---|---|---|---|---|
| A. 생성 정확도 | 90%+ | 90%+ | 90%+ | 90%+ |
| B. 입력 시 추론 정확도 | 73.9% | — | 44.7% | 81.2% |
| C. 토큰 효율 (JSON 대비) | 기준 | -11% | 최소 | -34~38% |
| 인간 가독성 | 낮음 | 중간 | 표 한정 | 높음 |
| 범용성 | 데이터 교환 특화 | 웹 특화 | 표 한정 | 문서 전반 |
표 10. 3개 차원 종합 비교.
핵심: JSON·HTML·CSV는 "LLM이 잘 만들어내는 포맷"이지 "LLM이 잘 이해하는 포맷"이 아니다. Markdown은 생성도 잘 하고(90%+), 이해도 잘 하며(81.2%), 토큰도 적게 쓰고(-34~38%), 사람도 읽기 쉬운 유일한 포맷이다.
6.6 비구조화 문서와의 격차
| 처리 방식 | 수치 | 출처 |
|---|---|---|
| 비구조화 PDF → 텍스트 추출 정확도 | 75% | PDFbench 12 |
| 비구조화 PDF → 구조 복원율 | 13% | PDFbench 12 |
| 비구조화 PDF → RAG F1 하락 | -14% | OHR-Bench 2 |
표 11. 비구조화 PDF의 처리 수치. "텍스트를 뽑았으니 괜찮다"는 가정이 위험한 이유.
%%{init: {'theme': 'neutral', 'themeVariables': {'fontSize': '13px', 'fontFamily': 'IBM Plex Sans, Pretendard, sans-serif'}}}%%
xychart-beta
    title "포맷별 LLM 이해·추론 정확도 (%)"
    x-axis ["MD(MMLU)", "PlainText", "YAML", "JSON(MMLU)", "MD-KV(Tbl)", "JSON(Tbl)", "CSV(Tbl)", "PDF구조"]
    y-axis "Accuracy (%)" 0 --> 90
    bar [81, 77, 75, 74, 61, 51, 45, 13]
그림 4. "입력 시 이해 정확도" 기준 비교. Markdown이 최상위, 비구조화 PDF가 최하위.
6.7 MDEval — LLM은 이미 마크다운을 이해한다
MDEval (arXiv 2025) 10은 LLM 마크다운 인식 능력 평가 최초 벤치마크이다.
| 발견 | 상세 |
|---|---|
| 자발적 구조 생성 | GPT-4o 등은 지시 없이도 Markdown 구조를 출력 |
| 능력 간 상관관계 | Markdown Awareness와 코딩·추론 능력 간 양의 Spearman 상관 |
| 향상 가능성 | QLoRA fine-tuning으로 개선 가능 (~20GB GPU, 13B) |
표 12. MDEval 핵심 발견.
Markdown이 이해에서 우위를 보이는 근본 이유: LLM 훈련 데이터에 Markdown이 압도적으로 포함되어 있기 때문이다. GitHub README, 기술 문서, 위키, 블로그 등 웹 상의 구조화된 텍스트 대부분이 Markdown으로 작성되어 있다.
7. 종합: 확인된 사실
7.1 확인된 사실
| 영역 | 확인된 사실 | 핵심 수치 | 근거 |
|---|---|---|---|
| OCR의 한계 | 모든 OCR이 RAG 성능을 저하시킴 | F1 -14% (최우수) | OHR-Bench 2 |
| 구조 보존 | 구조가 보존된 포맷이 평문보다 RAG에서 우위 | 6/6 QA 일관 우위 | HtmlRAG 3 |
| 레이아웃 | 공간 레이아웃 정보가 LLM 이해도에 직접 기여 | 14/16 SotA, +15~61% | DocLLM 4 |
| 구조 메타데이터 | 명시적 구조 인덱싱이 검색 recall을 극대화 | 90%+ Recall | LAD-RAG 5 |
| 멀티모달 | 텍스트-이미지 융합이 단일 모달리티보다 우위 | 68.4% vs 54.5% (이미지단독) | UniDoc-Bench 6 |
| 토큰 효율 | 구조화 포맷이 토큰을 절감 | 문서 전체 9-17% | KL3M 7 |
| 훈련 가치 | 구조화 문서가 훈련 데이터로서 높은 가치 | +25.8% vs GPT-4o | BigDocs 8 |
| 포맷 선택 | Markdown이 추론 태스크에서 최적 포맷 | 81.2% (GPT-4) | Prompt Format 9 |
| MD 인식 | LLM이 이미 Markdown을 이해하도록 훈련됨 | Spearman 양의 상관 | MDEval 10 |
| 포맷 스펙트럼 | JSON·HTML·CSV·MD가 AI 친화 포맷 군 형성 | 생성 90%+ | StructEval 11 |
| 구조 vs 텍스트 | 텍스트 75% 추출 가능해도 구조 복원은 13% | 구조 13% | PDFbench 12 |
| 이해 정확도 역전 | MD 입력 시 추론 정확도가 JSON보다 높음 | 81.2% vs 73.9% | Prompt Format 9 |
| 테이블 이해 | Markdown-KV가 11개 포맷 중 1위 | 60.7% vs JSON 50.8% | Improving Agents 13 |
| 토큰 효율 (포맷) | Markdown이 JSON 대비 34-38% 토큰 절감 | -34~38% | Improving Agents 14 |
표 13. 확인된 사실 종합.
9. 참고문헌
국가인공지능전략위원회, "국가AI전략위, 문서 작성 체계 혁신으로 AI 활용 기반 강화한다," 보도자료, 2026.3.5. https://aikorea.go.kr/web/board/brdDetail.do?menu_cd=000012&num=363 ↩ ↩
Zhang, J. et al., "OCR Hinders RAG: Evaluating the Cascading Impact of OCR on Retrieval-Augmented Generation," ICCV 2025, pp. 17443–17453. https://arxiv.org/abs/2412.02592 ↩ ↩ ↩ ↩
Tan, J. et al., "HtmlRAG: HTML is Better Than Plain Text for Modeling Retrieved Knowledge in RAG Systems," WWW 2025. https://arxiv.org/abs/2411.02959 ↩ ↩ ↩
Wang, D. et al., "DocLLM: A Layout-Aware Generative Language Model for Multimodal Document Understanding," ACL 2024, pp. 8529–8548. https://aclanthology.org/2024.acl-long.463/ ↩ ↩ ↩
Sourati, Z. et al., "LAD-RAG: Layout-aware Dynamic RAG for Visually-Rich Document Understanding," arXiv:2510.07233, 2025. https://arxiv.org/abs/2510.07233 ↩ ↩ ↩
Peng, X. et al., "UNIDOC-BENCH: A Unified Benchmark for Document-Centric Multimodal RAG," arXiv:2510.03663, 2025. https://arxiv.org/abs/2510.03663 ↩ ↩ ↩
Bommarito, M. et al., "KL3M Tokenizers," arXiv:2503.17247, 2025 (ALEA Institute). https://arxiv.org/abs/2503.17247 ↩ ↩ ↩ ↩
Rodriguez, J. et al., "BigDocs: An Open Dataset for Training Multimodal Models on Document and Code Tasks," ICLR 2025. https://arxiv.org/abs/2412.04626 ↩ ↩ ↩
He, J. et al., "Does Prompt Formatting Have Any Impact on LLM Performance?" arXiv:2411.10541, 2024. https://arxiv.org/abs/2411.10541 ↩ ↩ ↩ ↩
Li, Z. et al., "MDEval: Evaluating and Enhancing Markdown Awareness in Large Language Models," arXiv:2501.15000, 2025. https://arxiv.org/abs/2501.15000 ↩ ↩ ↩
Yang, J. et al., "StructEval: Benchmarking LLMs' Capabilities to Generate Structural Outputs," arXiv:2505.20139, 2025 (Univ. of Waterloo). https://arxiv.org/abs/2505.20139 ↩ ↩ ↩ ↩
Applied AI, "The State of PDF Parsing: What 800+ Documents and 7 Frontier LLMs Taught Us About Parser Selection," PDFbench, 2025. https://www.applied-ai.com/briefings/pdf-parsing-benchmark/ ↩ ↩ ↩ ↩
Improving Agents, "Which Table Format Do LLMs Understand Best? (Results for 11 Formats)," 2025. https://www.improvingagents.com/blog/best-input-data-format-for-llms/ ↩ ↩ ↩
Improving Agents, "Which Nested Data Format Do LLMs Understand Best? JSON vs. YAML vs. XML vs. Markdown," 2025. https://www.improvingagents.com/blog/best-nested-data-format/ ↩ ↩ ↩ ↩ ↩ ↩
Skyvern, "How we cut token count by 11% and boosted success rate by 3.9% by using HTML instead of JSON in our LLM calls," 2024. https://blog.skyvern.com/how-we-cut-token-count-by-11-and-boosted-success-rate-by-3-9-by-using-html-instead-of-json-in-our-llm-calls/ ↩
Markdown 엣지케이스 가이드 [중첩리스트]
보고된 증상
ordered list 항목 아래에 unordered list를 중첩할 때, 탭 키 2번이상 또는 특정 스페이스바 간격 이상 들여쓰기하면 하위 리스트가 렌더링되지 않는다.
렌더링 실패 예시:
1. 은하철도
        * 999
3. 메텔
위와 같이 * 999 앞에 일정 스페이스이상 (또는 탭 1개 이상)이 들어가면, * 999가 리스트 항목이 아닌 일반 텍스트로 렌더링된다.
원인
해당 현상은 CommonMark 스펙에 명시된 동작으로 확인된다.
BookStack은 프론트엔드(에디터 프리뷰)에서 markdown-it, 서버사이드(저장/열람/PDF)에서 league/commonmark을 사용하며, 두 파서 모두 CommonMark 스펙을 따른다.
CommonMark 스펙의 List Items 규칙 (Section 5.2)
스펙 원문 (CommonMark Spec 0.31.2, Section 5.2 — List items):
"Basic case. If a sequence of lines Ls constitute a sequence of blocks Bs starting with a character other than a space or tab, and M is a list marker of width W followed by 1 ≤ N ≤ 4 spaces of indentation, then the result of prepending M and the following spaces to the first line of Ls, and indenting subsequent lines of Ls by W + N spaces, is a list item with Bs as its contents."
핵심은 W + N 공식이다.
- W = 리스트 마커의 폭 (예:
1.→ 2,10.→ 3,*→ 1,-→ 1) - N = 마커 뒤의 공백 수 (1~4칸)
중첩 리스트가 부모의 하위 항목으로 인식되려면, 정확히 W + N칸만큼 들여쓰기해야 한다. 이보다 과도하게 들여쓰면 indented code block이나 paragraph continuation text로 해석된다.
실제 계산 예시
1. ㅅㅅㅅㅅ
^^^
|||
W=2 (리스트 마커 "1."의 폭)
 N=1 (마커 뒤 공백 1칸)
 → W + N = 3칸 들여쓰기 필요
따라서 중첩 리스트는 3칸 스페이스로 들여쓰기해야 한다:
1. ㅅㅅㅅㅅ
   * 999
3. ㅁㅁㅁ
* 999의 *이 ㅅ과 같은 열(4번째 열)에서 시작하는 것이 올바른 위치이다.
리스트 마커별 필요 들여쓰기
| 부모 리스트 마커 | W (마커 폭) | N (뒤 공백) | 필요 들여쓰기 (W+N) |
|---|---|---|---|
* , - , + |
1 | 1 | 2칸 |
1. ~ 9. |
2 | 1 | 3칸 |
10. ~ 99. |
3 | 1 | 4칸 |
100. ~ 999. |
4 | 1 | 5칸 |
과도한 들여쓰기 시 발생하는 문제
CommonMark 스펙에서 리스트 항목 내부의 indented code block은 W + N + 4칸 이상의 들여쓰기로 시작된다. 즉 1. 리스트 항목(W+N=3) 아래에서 7칸 이상 들여쓰기하면 코드 블록으로 해석될 수 있다.
또한 중첩 리스트 마커(*, -)가 부모 항목의 텍스트 시작 위치보다 훨씬 뒤에 있으면, 파서는 이를 리스트 마커로 인식하지 않고 일반 텍스트의 일부로 처리한다.
다른 플랫폼에서의 동작
이 동작은 BookStack만의 문제가 아니라 CommonMark 스펙을 따르는 모든 마크다운 파서에서 동일하게 발생한다.
| 플랫폼 / 파서 | CommonMark 기반 | 동일 증상 발생 |
|---|---|---|
| GitHub (GFM) | O | O |
| GitLab | O | O |
| markdown-it (BookStack 프론트엔드) | O | O |
| league/commonmark (BookStack 서버사이드) | O | O |
| Hugo (Goldmark) | O | O |
| marked.js | O | O |
| Bitbucket | 자체 구현 | O (4칸 고정 필요) |
| Python-Markdown | 자체 규칙 | O (4칸 고정, 더 엄격) |
CommonMark 스펙 Issue #399에서도 이 들여쓰기 규칙에 대한 사용자 혼란이 논의되었으나, 스펙 유지보수자들은 현재 규칙이 의도된 설계라는 입장이다.
Notion에서는 들여쓰기 동작이 코드블럭이 아닌경우 두번이상 원천적으로 불가능함.
올바른 작성법 가이드
기본 원칙
중첩 리스트의 마커(*, -, 1. 등)는 부모 항목의 텍스트 시작 위치에 맞춰 들여쓰기한다.
예시 1: ordered list 안에 unordered list
1. 첫 번째 항목
   * 하위 항목 A
   * 하위 항목 B
2. 두 번째 항목
   - 하위 항목 C
1. 뒤 텍스트가 4번째 열에서 시작하므로, 하위 리스트도 4번째 열에서 시작한다 (3칸 들여쓰기).
예시 2: unordered list 안에 ordered list
- 상위 항목
  1. 하위 번호 항목
  2. 하위 번호 항목
- 다른 항목
- 뒤 텍스트가 3번째 열에서 시작하므로, 하위 리스트도 3번째 열에서 시작한다 (2칸 들여쓰기).
예시 3: 다단계 중첩
1. 1단계
   * 2단계
     - 3단계
       1. 4단계
각 단계마다 부모의 텍스트 시작 위치에 맞춘다.
피해야 할 패턴
❌ 탭 키 사용 (에디터마다 탭 폭이 다름)
1. 항목
	* 하위 항목

❌ 과도한 스페이스
1. 항목
        * 하위 항목

❌ 텍스트 위치와 무관한 임의 들여쓰기
1. 항목
      * 하위 항목
외부 문서에서 붙여넣기할 때 주의사항
다른 에디터(Word, Notion, 메모장 등)에서 작성된 마크다운을 BookStack에 붙여넣을 때, 들여쓰기가 탭이나 과도한 스페이스로 되어 있을 수 있다. 이 경우 중첩 리스트가 정상 렌더링되지 않으므로, 붙여넣기 후 들여쓰기를 위 규칙에 맞게 조정해야 한다.
간단한 확인법: 프리뷰 패널에서 하위 리스트가 제대로 표시되는지 확인한다. 프리뷰에서 깨지면 저장 후에도 깨진다.
레퍼런스
| 문서 | URL |
|---|---|
| CommonMark Spec 0.31.2 — Section 5.2: List items | https://spec.commonmark.org/0.31.2/#list-items |
| CommonMark Spec — Motivation (들여쓰기 규칙 설계 의도) | https://spec.commonmark.org/0.31.2/#motivation |
| CommonMark Tutorial — Nested Lists | https://commonmark.org/help/tutorial/10-nestedLists.html |
| CommonMark Spec Issue #399 — 들여쓰기 규칙 논의 | https://github.com/commonmark/commonmark-spec/issues/399 |
| GitHub Flavored Markdown Spec (CommonMark 기반) | https://github.github.com/gfm/ |
| markdown-it Issue #215 — 중첩 리스트 들여쓰기 | https://github.com/markdown-it/markdown-it/issues/215 |
| Markdown Guide — Basic Syntax (Lists) | https://www.markdownguide.org/basic-syntax/#lists-1 |
Mermaid 엣지케이스 가이드 [복잡도]
보고된 증상
Mermaid 다이어그램에 노드를 많이 추가하고, 서브그래프를 중첩하고, <br/>로 줄바꿈을 넣거나 HTML 서식 태그를 사용하면 다이어그램이 의도대로 렌더링되지 않는다. 구체적으로는 노드가 예상 밖의 위치에 배치되거나, 엣지가 다른 노드를 관통하거나, 레이아웃이 작은 변경에도 급격하게 바뀌는 현상이 발생한다.
이 현상은 Mermaid 자체의 설계 범위에서 비롯되는 한계이다.
case 1: 복잡한 서버 구성 아키텍처를 Mermaid로 옮겼을 때
아래는 실제 서버 구성을 Mermaid flowchart로 표현한 예시이다. 외부 트래픽이 로드밸런서를 거쳐 웹 서버, API 서버, 워커로 분기되고, 각 컴포넌트가 데이터베이스와 캐시에 연결되는 일반적인 구성이다.
복잡한 다이어그램 예시:
flowchart TD
    subgraph External ["외부"]
        Client["클라이언트"] --> DNS["DNS"] --> CDN["CDN"]
    end

    subgraph LB ["로드밸런서"]
        WAF["WAF"] --> ALB["ALB"]
    end

    subgraph App ["애플리케이션"]
        subgraph Web ["Web Tier"]
            Web1["Web #1<br/>(Nginx)"]
            Web2["Web #2<br/>(Nginx)"]
        end
        subgraph API ["API Tier"]
            API1["API #1<br/>(Node.js)"]
            API2["API #2<br/>(Node.js)"]
            API3["API #3<br/>(Node.js)"]
        end
    end

    subgraph Data ["데이터"]
        Primary["MySQL Primary"]
        Replica["MySQL Replica"]
        Redis["Redis"]
        S3["S3"]
        SQS["SQS"]
    end

    Worker["Worker (×3)"]

    CDN --> WAF
    ALB --> Web1 & Web2
    ALB --> API1 & API2 & API3
    Web1 & Web2 --> API1 & API2 & API3
    API1 & API2 & API3 --> Primary & Replica & Redis & S3
    API1 & API2 & API3 --> SQS --> Worker
    Worker --> Primary & S3
    Primary --> Replica
이 다이어그램은 노드 18개, 서브그래프 5개, 엣지 20개 이상을 포함한다. 실제로 렌더링해보면 다음 문제를 확인할 수 있다.
API 서버 3대가 데이터베이스, 캐시, 스토리지에 동시에 연결되면서 엣지가 교차하고, 어떤 선이 어디에서 어디로 가는지 추적하기 어렵다. Dagre 레이아웃 엔진이 노드를 예측 불가능한 위치에 배치하며, 서브그래프 간 간격이 불균일해진다. 읽는 사람이 이 다이어그램에서 트래픽 흐름을 파악하려면 한참을 들여다봐야 한다.
동일한 구성을 분할한 예시:
동일한 정보를 2개의 간결한 다이어그램으로 나누면 각각이 훨씬 명확해진다.
Diagram1
flowchart TD
    Client["클라이언트"] --> CDN --> WAF --> ALB
    ALB --> Web["Web (×2)"]
    ALB --> API["API (×3)"]
    API --> DB["MySQL Primary + Replica"]
    API --> Redis["Redis"]
    API --> S3["S3"]
    API --> SQS --> Worker["Worker (×3)"]
    Worker --> DB
Diagram2
flowchart LR
    Primary["MySQL Primary"] --> Replica["MySQL Replica"]
    Worker["Worker"] --> Primary
    Worker --> S3["S3"]
첫 번째 다이어그램은 트래픽 흐름을 5초 안에 파악할 수 있다. 두 번째는 데이터 쓰기 경로만 별도로 보여준다. 복잡한 하나보다 간결한 둘이 낫다.
case 2: HTML 라벨을 과도하게 사용했을 때
Mermaid 노드에는 <br/>로 줄바꿈을 넣고, <b>, <i> 등 HTML 서식 태그를 사용할 수 있다. 이 기능은 htmlLabels: true(기본값) 설정에서 SVG 내부의 <foreignObject> 태그를 통해 동작한다.
문법적으로 허용되고 동작도 하지만, HTML 라벨이 많아질수록 두 가지 문제가 심화된다.
가독성 저하 — 노드 크기 비대화:
flowchart TD
    subgraph Agent ["exdp.exe"]
        direction TB
        WSS["<b>WSS 서버</b><br/>(Port: 13440)<br/><i>WebSocket Secure</i>"]
        PKG["<b>패키지 식별자</b><br/>(Package Identifier)<br/><i>DLL 매핑 관리</i>"]
        WMng["<b>Worker Manager</b><br/>(IPC Client)<br/><i>Protobuf 통신</i>"]
    end

    subgraph Worker ["exdp-worker.exe"]
        direction TB
        IPC["<b>IPC Server</b><br/>(Named Pipe)<br/><i>프로세스 간 통신</i>"]
        Loader["<b>DLL 로더</b><br/>(Dynamic Loading)<br/><i>런타임 바인딩</i>"]
    end

    WSS -->|"호출 요청"| WMng
    WMng <-->|"Protobuf 직렬화"| IPC
    IPC -->|"LoadLibrary"| Loader
    PKG -->|"DLL 경로 조회"| WMng
각 노드에 <b>, <i>, <br/>가 3줄씩 들어가면서 노드 박스가 커지고, 실제로 중요한 연결 관계(화살표)가 상대적으로 눈에 들어오지 않는다. 다이어그램의 목적은 컴포넌트 간 관계를 보여주는 것인데, 각 노드의 상세 설명이 그 관계를 가린다.
동일한 구성을 간결하게 작성한 예시:
flowchart TD
    subgraph Agent ["exdp.exe"]
        WSS["WSS 서버"] --> WMng["Worker Manager"]
        PKG["패키지 식별자"] --> WMng
    end

    subgraph Worker ["exdp-worker.exe"]
        IPC["IPC Server"] --> Loader["DLL 로더"]
    end

    WMng <-->|Protobuf| IPC
노드 라벨을 핵심 이름만 남기니 컴포넌트 간 관계가 한눈에 보인다. Port 번호, 프로토콜 상세, 기술 스택 설명은 다이어그램 아래 본문에 텍스트로 보충하면 된다.
PDF 내보내기의 추가 제약 — foreignObject:
HTML 라벨은 브라우저에서는 정상 동작하지만, PDF 내보내기에서는 별도의 처리가 필요하다. Mermaid가 htmlLabels: true로 생성한 SVG에는 <foreignObject> 태그 안에 HTML이 포함되는데, PDF 변환을 담당하는 WeasyPrint는 이 태그를 지원하지 않아 라벨 텍스트가 사라진다. BookStack에서는 이 문제를 우회하기 위해 PDF 내보내기 시 Mermaid를 PNG 이미지로 변환하여 삽입하는 방식을 채택했다. 이 과정에서 블록당 Chromium 기동 오버헤드가 발생하므로, HTML 라벨이 많은 복잡한 다이어그램일수록 내보내기가 느려진다.
Mermaid의 설계 목적
Mermaid 프로젝트의 공식 문서는 다음과 같이 명시한다:
"The main purpose of Mermaid is to help documentation catch up with development. Doc-Rot is a Catch-22 that Mermaid helps to solve."
— Mermaid 공식 문서 (mermaid.js.org/intro)
Mermaid는 마크다운처럼 텍스트로 빠르게 다이어그램을 작성하고, 버전 관리 가능한 형태로 문서에 포함시키기 위해 만들어졌다. 창시자 Knut Sveidqvist는 Packt 출판사 인터뷰에서 "문서화가 번거롭고 지루할 필요가 없다"고 밝혔으며, Mermaid Chart 블로그에서는 UML 다이어그램이 지나치게 포괄적이 되어 오히려 개발자의 시간을 낭비하고 있었다는 문제의식을 공유한 바 있다.
특히 Mermaid 공식 Flowchart 문서에는 스웨덴어 개념인 "lagom" (너무 많지도 적지도 않은 적당함)이 직접 언급되어 있다. 과도한 체이닝은 가독성을 떨어뜨리며, lagom 원칙이 적용된다는 것이다. 스웨덴인인 Knut Sveidqvist가 이 원칙을 문서에 직접 포함시킨 것은 Mermaid의 설계 철학을 단적으로 보여준다.
Dagre 레이아웃 엔진의 구조적 한계
Mermaid의 기본 레이아웃 엔진인 Dagre는 노드와 엣지가 많아질수록 배치 품질이 떨어진다. 이 문제는 Mermaid 프로젝트 자체가 인정하고 있으며, 그 결과 ELK(Eclipse Layout Kernel)라는 대체 레이아웃 엔진을 추가했다.
Mermaid 공식 문서에는 다음과 같이 설명되어 있다:
"ELK: For those who need more sophisticated layout capabilities, especially when working with large or intricate diagrams, the ELK layout offers advanced options."
— Mermaid Syntax Reference (mermaid.js.org/intro/syntax-reference.html)
Dagre에서 ELK로의 전환을 요청한 GitHub Issue #1969에서는, 큰 다이어그램에서 연결이 하나뿐인 블록이 다이어그램 전체를 가로질러 예상 밖의 위치에 배치되고, 엣지가 다른 블록을 관통하는 문제가 보고되었다. 이 이슈는 Knut Sveidqvist 본인이 담당자로 지정되었다.
경험이 풍부한 개발자들의 평가도 일관적이다. Korny Sietsma는 "Mermaid의 엔진은 훨씬 혼란스럽고, 작은 변경이 전체 레이아웃을 급격하게 바꾼다"고 지적했으며, 자신은 단순한 것에는 Mermaid를, 복잡하거나 레이아웃 제어가 필요한 것에는 Excalidraw를 사용한다고 밝혔다.
foreignObject와 PDF 렌더링 파이프라인
Mermaid가 htmlLabels: true(기본값)로 생성한 SVG에는 <foreignObject> 태그 안에 HTML 라벨이 포함된다. 브라우저(Chromium)는 이를 정상적으로 렌더링하지만, PDF 변환을 담당하는 WeasyPrint는 <foreignObject>를 지원하지 않는다.
이것은 WeasyPrint만의 문제가 아니다. draw.io 프로젝트의 Issue #3350에서도 foreignObject를 처리할 수 있는 SVG 렌더러는 브라우저뿐이라는 점이 확인되었으며, CairoSVG의 공식 SVG 1.1 지원 목록에도 foreignObject는 누락되어 있다. WeasyPrint Issue #1441에서 코어 메인테이너 Guillaume Ayoub(liZe)는 foreignObject 구현의 난이도를 언급했고, 이 이슈는 4년 이상 오픈 상태로 남아 있다.
결과적으로, Mermaid 노드에 HTML 라벨을 사용할수록 브라우저 렌더링과 PDF 출력 사이의 일관성 유지에 더 많은 처리가 필요해진다. BookStack에서는 이를 PNG 변환으로 우회했으나, 이 방식에는 블록당 Chromium 기동 오버헤드와 래스터 품질 저하라는 비용이 수반된다.
올바른 작성법 가이드
기본 원칙
Mermaid 다이어그램은 시스템의 전체 구현을 담는 것이 아니라, 핵심 흐름을 요약하는 것이다. 읽는 사람이 5초 안에 전체 구조를 파악할 수 있어야 한다.
적정 규모:
노드 3~15개, 서브그래프 1~2단계 중첩까지가 Mermaid의 최적 사용 범위이다. 노드가 20개를 넘어가면 다이어그램을 분할하거나, 복잡한 레이아웃 제어가 필요한 경우 draw.io, Excalidraw 등 다른 도구를 고려한다.
복잡한 다이어그램을 분할하는 방법
하나의 복잡한 다이어그램 대신, 관심사 별로 분리된 여러 개의 간결한 다이어그램을 사용한다.
예를 들어 앞서 본 서버 아키텍처를 문서화할 때, 하나의 다이어그램에 모든 것을 넣는 대신 "트래픽 흐름", "데이터 쓰기 경로", "모니터링"으로 나누어 각각 별도의 다이어그램으로 작성하면, 각 다이어그램이 하나의 관심사에 집중하므로 읽는 사람이 필요한 정보를 빠르게 찾을 수 있다.
노드 라벨은 짧게 유지한다
<br/>로 한 노드에 여러 줄을 넣어야 할 정도로 텍스트가 길다면, 그 노드는 더 작은 단위로 분할하거나 약어를 사용하는 것이 낫다. Port 번호, 프로토콜 상세, 기술 스택 같은 부가 정보는 다이어그램 아래 본문에 텍스트로 보충한다.
<br/>와 HTML 서식 태그(<b>, <i> 등)는 문법적으로 허용되며, BookStack에서 브라우저 렌더링과 PDF 내보내기 모두 정상 동작한다. 사용을 금지하는 것이 아니라, 다이어그램의 가치가 시각적 단순함에 있다는 점을 고려하여 최소한으로 사용하는 것을 권장한다.
한 페이지에 다이어그램 수를 제한한다
PDF 내보내기 시 Mermaid 블록마다 Chromium이 기동되므로, 블록이 많을수록 내보내기 시간이 선형적으로 증가한다. 한 페이지에 5개 이상의 다이어그램이 필요하다면 페이지를 분할하는 것을 권장한다.
피해야 할 패턴
노드 수 과다:
flowchart TD
    A --> B & C & D & E
    B --> F & G
    C --> H & I & J
    D --> K & L
    E --> M & N & O
    F --> P
    G --> Q & R
노드가 20개를 넘어가면 Dagre 레이아웃이 불안정해지고, 한 곳을 수정하면 전혀 다른 곳의 배치가 바뀌는 현상이 발생한다. 이 시점에서 다이어그램을 분할해야 한다.
서브그래프 3단계 이상 중첩:
flowchart TD
    subgraph A ["1단계"]
        subgraph B ["2단계"]
            subgraph C ["3단계"]
                subgraph D ["4단계"]
                    Node["깊이 4"]
                end
            end
        end
    end
서브그래프가 깊어질수록 레이아웃 엔진의 공간 할당이 비효율적이 되어 다이어그램의 대부분이 빈 여백으로 채워진다. 2단계까지가 가독성의 실질적 한계이다.
HTML 라벨 과다 사용:
flowchart TD
    A["<b>서비스 A</b><br/>(v2.3.1)<br/><i>Java 17</i><br/>Port: 8080"]
    B["<b>서비스 B</b><br/>(v1.0.0)<br/><i>Go 1.21</i><br/>Port: 9090"]
    A -->|"gRPC<br/>(TLS 1.3)"| B
노드 하나에 4줄씩 들어가면 노드 박스가 커져서, 정작 중요한 연결 관계(화살표)가 눈에 들어오지 않는다. 또한 이 HTML 라벨은 내부적으로 SVG의 <foreignObject>를 통해 렌더링되므로, 브라우저 이외의 SVG 소비자(PDF 변환기, Inkscape 등)에서 호환성 문제를 일으킬 수 있다.
다른 플랫폼에서의 동작
이 한계는 BookStack만의 문제가 아니라 Mermaid를 사용하는 모든 플랫폼에서 동일하게 발생한다.
| 플랫폼 / 도구 | Mermaid 지원 | 동일 복잡도 한계 |
|---|---|---|
| GitHub (GFM) | O | O |
| GitLab | O | O |
| Notion | O | O |
| Obsidian | O | O |
| VS Code (미리보기) | O | O |
| Mermaid Live Editor | O | O |
Mermaid의 복잡도 한계는 Dagre/ELK 레이아웃 엔진의 동작 방식에서 비롯되므로, 어떤 플랫폼에서 렌더링하든 동일하게 적용된다.
간단한 확인법: Mermaid Live Editor(https://mermaid.live)에서 다이어그램을 먼저 작성해보고, 레이아웃이 의도대로 나오는지 확인한 후 BookStack에 붙여넣는다. Live Editor에서 깨지면 BookStack에서도 깨진다.
레퍼런스
| 문서 | URL |
|---|---|
| Mermaid 공식 문서 — About | https://mermaid.js.org/intro/ |
| Packt 인터뷰 — Knut Sveidqvist | https://partnerships.packt.com/31533-2/ |
| Mermaid Chart 블로그 — UML 한계 | https://mermaid.ai/blog/posts/uml-diagram-tool |
| Mermaid 공식 Flowchart 문서 (lagom 원칙) | https://mermaid.js.org/syntax/flowchart.html |
| Mermaid Syntax Reference — ELK 레이아웃 | https://mermaid.js.org/intro/syntax-reference.html |
| GitHub Issue #1969 — Dagre→ELK 전환 요청 | https://github.com/mermaid-js/mermaid/issues/1969 |
| Korny's Blog — Revisiting Mermaid.js | https://blog.korny.info/2025/03/14/mermaid-js-revisited |
| WeasyPrint Issue #1441 — foreignObject 미지원 | https://github.com/Kozea/WeasyPrint/issues/1441 |
| CairoSVG SVG 1.1 지원 현황 | https://cairosvg.org/svg_support/ |
| draw.io Issue #3350 — foreignObject 생태계 한계 | https://github.com/jgraph/drawio/issues/3350 |
| Mermaid Issue #2688 — foreignObject→SVG 전환 요청 | https://github.com/mermaid-js/mermaid/issues/2688 |
test
BookStack PDF Export 전처리 파이프라인 분석
대상: BookStack v25.02.4 커스터마이징 참여 개발자 범위: Mermaid 다이어그램이 포함된 페이지의 PDF 내보내기 경로 최종 수정: 2026-03-24
1. 개요
BookStack의 PDF 내보내기는 WeasyPrint(CSS 기반 PDF 렌더링 엔진)를 사용한다.
WeasyPrint는 브라우저가 아니기 때문에 JavaScript를 실행할 수 없고,
SVG 내부의 <foreignObject>도 지원하지 않는다.
이 제약이 Mermaid 다이어그램 PDF 출력의 핵심 문제였으며,
최종적으로 PNG 이미지 방식으로 해결했다.
이 문서는 PDF export 요청이 들어왔을 때 HTML이 어떤 전처리를 거쳐 WeasyPrint에 도달하는지를 단계별로 분석한다.
2. 전체 파이프라인 흐름
사용자 → PDF 내보내기 클릭
  │
  ▼
pageToPdf($page)                          [ExportFormatter.php]
  │
  ├─ PageContent($page)->render()          Markdown → HTML 변환
  │
  ├─ view('exports.page')                  Blade 템플릿 렌더링
  │   └─ format=pdf, engine=command          (CSS/레이아웃 포함)
  │
  └─ htmlToPdf($html)                     ★ 전처리 시작
      │
      ├─ 1. containHtml($html)             이미지 base64, 링크 절대경로
      │
      ├─ 2. HtmlDocument 로드              DOM 파싱
      │
      ├─ 3. replaceIframesWithLinks()      iframe → 링크 텍스트
      │
      ├─ 4. openDetailElements()           <details> 태그 열기
      │
      ├─ 5. replaceMermaidWithImage()      ★ Mermaid → PNG 변환
      │
      ├─ 6. pdfGenerator->fromHtml()       WeasyPrint 실행
      │
      └─ 7. cleanupMermaidTempFiles()      임시 PNG 삭제 (finally)
2.1 전체 파이프라인 다이어그램
flowchart TD
    A["사용자: PDF 내보내기 클릭"] --> B["pageToPdf($page)"]
    B --> C["PageContent($page)->render()<br/>Markdown → HTML 변환"]
    C --> D["view('exports.page')<br/>format=pdf, engine=command"]
    D --> E["htmlToPdf($html)"]

    subgraph htmlToPdf ["htmlToPdf — 전처리 허브"]
        direction TB
        E1["① containHtml($html)<br/>이미지 base64 · 링크 절대경로"]
        E2["② HtmlDocument 로드<br/>DOM 파싱"]
        E3["③ replaceIframesWithLinks()"]
        E4["④ openDetailElements()"]
        E5["⑤ replaceMermaidWithImage()<br/>Puppeteer+mmdc → PNG"]
        E6["⑥ pdfGenerator→fromHtml()<br/>WeasyPrint 실행"]
        E7["⑦ cleanupMermaidTempFiles()<br/>finally 블록"]
        E1 --> E2 --> E3 --> E4 --> E5 --> E6 --> E7
    end

    E --> E1

    style E5 fill:#f4845f,color:#fff
    style E6 fill:#f0ad4e,color:#fff
    style E1 fill:#5bc0de,color:#fff
2.2 replaceMermaidWithImage 내부 흐름
flowchart TD
    S["XPath 쿼리<br/>pre > code.language-mermaid"] --> LOOP

    subgraph LOOP ["foreach block"]
        direction TB
        L1["다이어그램 소스 추출<br/>html_entity_decode(textContent)"]
        L2["임시 .mmd 파일 생성<br/>/tmp/mmd_in_xxx.mmd"]
        L3["mmdc 실행<br/>node cli.js -i input -o output.png -s 2"]
        L4["@unlink 입력 파일"]
        L5{"성공?<br/>exitCode===0<br/>filesize > 0"}
        L6["DOM에 img 삽입<br/>src=file:///tmp/xxx.png"]
        L7["mermaidTempFiles에<br/>경로 추가"]
        L8["@unlink 출력 파일"]

        L1 --> L2 --> L3 --> L4 --> L5
        L5 -- "성공" --> L6 --> L7
        L5 -- "실패" --> L8
    end

    style L3 fill:#f4845f,color:#fff
    style L6 fill:#5bc0de,color:#fff
2.3 htmlLabels 설정별 렌더링 경로 비교
flowchart TD
    SRC["Mermaid 소스코드"] --> PATH_OLD
    SRC --> PATH_NEW

    subgraph PATH_OLD ["과거: SVG 직접 삽입 ✗"]
        direction TB
        O1["htmlLabels: true<br/>mmdc → SVG"]
        O2["SVG 내부 foreignObject<br/>HTML div로 라벨 렌더링"]
        O3["WeasyPrint 렌더링<br/>foreignObject 미지원"]
        O4["PDF 텍스트 누락 ✗"]
        O1 --> O2 --> O3 --> O4
    end

    subgraph PATH_NEW ["현재: PNG 이미지 삽입 ✓"]
        direction TB
        N1["htmlLabels: true<br/>mmdc → PNG (-s 2)"]
        N2["Puppeteer(Chromium)가<br/>완벽히 렌더링"]
        N3["file:// 경로로<br/>img 태그 삽입"]
        N4["PDF 정상 출력 ✓"]
        N1 --> N2 --> N3 --> N4
    end

    style O4 fill:#d9534f,color:#fff
    style N4 fill:#5cb85c,color:#fff
3. 각 단계 상세
3.1 pageToPdf — 진입점
// app/Exports/ExportFormatter.php
public function pageToPdf(Page $page): string
{
    $page->html = (new PageContent($page))->render();
    $html = view('exports.page', [
        'page'   => $page,
        'format' => 'pdf',
        'engine' => $this->pdfGenerator->getActiveEngine(),
        'locale' => user()->getLocale(),
    ])->render();

    return $this->htmlToPdf($html);
}
PageContent->render()는 마크다운 소스를 HTML로 변환한다.
이 시점에서 Mermaid 코드 블록은 아직
<pre><code class="language-mermaid"> 형태로 남아 있다.
JavaScript 실행 없이 순수 HTML 문자열이다.
3.2 htmlToPdf — 전처리 허브
이 메서드가 전처리의 핵심이다. 모든 변환이 여기서 순서대로 실행된다.
protected function htmlToPdf(string $html): string
{
    // 1단계: 이미지 base64 인코딩 + 링크 절대경로 변환
    $html = $this->containHtml($html);

    // DOM 파싱
    $doc = new HtmlDocument();
    $doc->loadCompleteHtml($html);

    // 2단계: iframe을 링크 텍스트로 교체
    $this->replaceIframesWithLinks($doc);

    // 3단계: <details> 요소를 열린 상태로
    $this->openDetailElements($doc);

    // 4단계: Mermaid → PNG (반드시 containHtml 이후에 실행)
    $this->replaceMermaidWithImage($doc);

    $cleanedHtml = $doc->getHtml();

    // 5단계: WeasyPrint로 PDF 생성 → 6단계: 임시 파일 정리
    try {
        return $this->pdfGenerator->fromHtml($cleanedHtml);
    } finally {
        $this->cleanupMermaidTempFiles();
    }
}
실행 순서가 중요한 이유:
containHtml()은 <img> 태그의 src를 base64로 변환하는데,
replaceMermaidWithImage()가 삽입하는 PNG는 file:// 경로를 사용한다.
만약 순서가 뒤바뀌면 containHtml()이 file:// 경로를 base64 변환하려 시도할 수 있다.
이를 방지하기 위해 containHtml()에 file:// 가드를 추가했다.
3.3 containHtml — 이미지/링크 전처리
protected function containHtml(string $htmlContent): string
{
    // 이미지 처리: src를 base64 data URI로 변환
    preg_match_all("/\<img.*?src\=(\'|\")(.*?)(\'|\").*?\>/i",
        $htmlContent, $imageTagsOutput);

    if (isset($imageTagsOutput[0]) && count($imageTagsOutput[0]) > 0) {
        foreach ($imageTagsOutput[0] as $index => $imgMatch) {
            $oldImgTagString = $imgMatch;
            $srcString = $imageTagsOutput[2][$index];

            // ★ file:// 경로 가드 — Mermaid PNG 임시 파일 보호
            if (str_starts_with($srcString, 'file://')) {
                continue;
            }

            $imageEncoded = $this->imageService->imageUrlToBase64($srcString);
            if ($imageEncoded === null) {
                $imageEncoded = $srcString;
            }
            $newImgTagString = str_replace(
                $srcString, $imageEncoded, $oldImgTagString);
            $htmlContent = str_replace(
                $oldImgTagString, $newImgTagString, $htmlContent);
        }
    }

    // 링크 처리: 상대 경로를 절대 URL로 변환
    // 단, #으로 시작하는 앵커 링크는 제외 (각주 등 문서 내 링크 보존)
    preg_match_all("/\<a.*href\=(\'|\")(.*?)(\'|\").*?\>/i",
        $htmlContent, $linksOutput);

    if (isset($linksOutput[0]) && count($linksOutput[0]) > 0) {
        foreach ($linksOutput[0] as $index => $linkMatch) {
            $oldLinkString = $linkMatch;
            $srcString = $linksOutput[2][$index];
            if (!str_starts_with(trim($srcString), 'http')
                && !str_starts_with(trim($srcString), '#')) {
                $newSrcString = url($srcString);
                $newLinkString = str_replace(
                    $srcString, $newSrcString, $oldLinkString);
                $htmlContent = str_replace(
                    $oldLinkString, $newLinkString, $htmlContent);
            }
        }
    }
    return $htmlContent;
}
주의 사항:
file://가드가 없으면 Mermaid PNG 경로를imageUrlToBase64()에 넘기게 되어, 스토리지 경로 변환 실패로 null이 반환된다.- 앵커 링크(
#fn1,#fnref1)를 절대 URL로 변환하면 PDF 내 각주 링크가 깨진다. 이 수정은 각주 기능 구현 시 추가되었다.
3.4 replaceMermaidWithImage — 핵심 변환
이 메서드가 Mermaid 코드 블록을 PNG 이미지로 교체하는 핵심 로직이다.
protected function replaceMermaidWithImage(HtmlDocument $doc): void
{
    $blocks = $doc->queryXPath(
        '//pre/code[contains(@class, "language-mermaid")]'
    );
    \Log::debug('Mermaid blocks: ' . $blocks->length);

    $nodePath       = '/usr/local/bin/node';
    $mmdcScript     = '/var/www/bookstack/node_modules/'
                    . '@mermaid-js/mermaid-cli/src/cli.js';
    $puppeteerConfig = base_path('puppeteer-config.json');

    if (!file_exists($mmdcScript)) {
        \Log::debug('mmdc script not found');
        return;
    }

    $blockArray = iterator_to_array($blocks);
    foreach ($blockArray as $block) {
        $pre  = $block->parentNode;
        $code = html_entity_decode($block->textContent, ENT_QUOTES);

        // 임시 파일 생성
        $tmpIn  = tempnam(sys_get_temp_dir(), 'mmd_in_') . '.mmd';
        $tmpOut = tempnam(sys_get_temp_dir(), 'mmd_out_') . '.png';

        file_put_contents($tmpIn, $code);

        // mmdc 실행: Puppeteer(Chromium) → PNG
        $cmd = sprintf(
            'PUPPETEER_CACHE_DIR=/var/www/bookstack/storage/puppeteer '
            . '%s %s -i %s -o %s -c %s --puppeteerConfigFile %s -s 2 2>&1',
            $nodePath,
            $mmdcScript,
            escapeshellarg($tmpIn),
            escapeshellarg($tmpOut),
            escapeshellarg(base_path('mermaid-config.json')),
            escapeshellarg($puppeteerConfig)
        );

        $output = [];
        exec($cmd, $output, $exitCode);
        \Log::debug('exit: ' . $exitCode
            . ' png exists: ' . (file_exists($tmpOut) ? 'yes' : 'no')
            . ' output: ' . implode(' ', $output));

        // 입력 파일은 즉시 삭제
        @unlink($tmpIn);

        if ($exitCode === 0 && file_exists($tmpOut)
            && filesize($tmpOut) > 0) {
            // DOM에 <img> 삽입 — file:// 경로 참조
            $img = $doc->createElement('img');
            $img->setAttribute('src', 'file://' . $tmpOut);
            $img->setAttribute('style',
                'max-width:100%; height:auto;');
            $img->setAttribute('class', 'mermaid-diagram');

            $wrapper = $doc->createElement('div');
            $wrapper->setAttribute('class',
                'mermaid-diagram-wrapper');
            $wrapper->setAttribute('style',
                'text-align:center; margin:1em 0;');
            $wrapper->appendChild($img);

            $pre->parentNode->replaceChild($wrapper, $pre);

            // WeasyPrint가 읽을 때까지 PNG 유지
            $this->mermaidTempFiles[] = $tmpOut;
            \Log::debug('PNG file referenced: ' . $tmpOut
                . ' (' . filesize($tmpOut) . ' bytes)');
        } else {
            @unlink($tmpOut);
        }
    }
}
mmdc 명령어 옵션 설명
| 옵션 | 값 | 역할 |
|---|---|---|
-i |
입력 .mmd 파일 | Mermaid 소스 |
-o |
출력 .png 파일 | PNG 형식 지정 (확장자로 결정) |
-c |
mermaid-config.json |
Mermaid 설정 (theme 등) |
--puppeteerConfigFile |
puppeteer-config.json |
Chromium 실행 옵션 |
-s 2 |
스케일 팩터 | 2배 해상도 출력 |
설정 파일 내용
// mermaid-config.json — htmlLabels: true(기본값) 사용
{
  "theme": "default"
}

// puppeteer-config.json
{
  "args": ["--no-sandbox", "--disable-setuid-sandbox"],
  "cacheDirectory": "/var/www/bookstack/storage/puppeteer"
}
3.5 cleanupMermaidTempFiles — 임시 파일 정리
protected function cleanupMermaidTempFiles(): void
{
    foreach ($this->mermaidTempFiles as $tmpFile) {
        if (file_exists($tmpFile)) {
            @unlink($tmpFile);
            \Log::debug('Cleaned up Mermaid temp file: ' . $tmpFile);
        }
    }
    $this->mermaidTempFiles = [];
}
try/finally로 호출되므로 PDF 생성 성공/실패와 무관하게 실행된다.
이전에 대용량 이미지로 인한 메모리 초과 경험이 있어,
임시 파일이 /tmp에 누적되는 것을 방지하기 위해 이 패턴을 사용한다.
4. 왜 PNG인가 — 의사결정 기록
4.1 시도한 접근들
| 시도 | 방식 | 결과 | 실패 원인 |
|---|---|---|---|
| 1차 | SVG + htmlLabels: true |
텍스트 누락 | WeasyPrint가 SVG 내 <foreignObject> 미지원 |
| 2차 | SVG + htmlLabels: false |
특수문자 깨짐 | Mermaid 자체 버그 — <br/>, \, &, <> 처리 불량 |
| 최종 | PNG + htmlLabels: true |
정상 | Puppeteer가 완벽히 렌더링한 결과를 래스터 이미지로 캡처 |
4.2 htmlLabels 설정의 영향
htmlLabels는 Mermaid가 노드 라벨을 렌더링하는 방식을 결정한다.
htmlLabels: true (기본값) — HTML/CSS로 라벨 렌더링:
<svg>
  <foreignObject>
    <div xmlns="http://www.w3.org/1999/xhtml">
      <span>노드 텍스트</span>
    </div>
  </foreignObject>
</svg>
htmlLabels: false — 순수 SVG 텍스트 요소:
<svg>
  <text>
    <tspan>노드 텍스트</tspan>
  </text>
</svg>
PNG 방식에서는 Puppeteer(Chromium)가 렌더링을 완료한 뒤 스크린샷을 찍으므로,
<foreignObject> 문제가 발생하지 않는다.
따라서 htmlLabels: true(기본값)를 사용하여
줄바꿈, 특수문자, 긴 텍스트 등을 정상 처리한다.
4.3 임시 파일 참조 vs base64 인라인
| base64 인라인 | 임시 파일 참조 (채택) | |
|---|---|---|
| PHP 메모리 | 높음 (이미지 데이터 전체 로드) | 낮음 (경로 문자열만) |
| PDF 생성 속도 | 느림 (HTML 문자열 비대) | 빠름 |
| 과거 문제 | base64로 HTML 크기 폭증 → 변환 중 뻗음 | 없음 |
| 임시 파일 관리 | 불필요 | 필요 (finally로 해결) |
5. 실행 환경 의존성
| 컴포넌트 | 경로 / 설정 | 용도 |
|---|---|---|
| Node.js | /usr/local/bin/node |
mmdc 실행 (nvm이 아닌 복사본 — www-data 접근 가능) |
| mmdc | node_modules/@mermaid-js/mermaid-cli/src/cli.js |
Mermaid → PNG 변환 |
| Puppeteer cache | /var/www/bookstack/storage/puppeteer |
Chromium 바이너리 저장 |
| chrome-headless-shell | storage/puppeteer 하위 | Puppeteer가 사용하는 브라우저 |
| WeasyPrint | 시스템 명령어 | HTML → PDF 최종 변환 |
| mermaid-config.json | /var/www/bookstack/mermaid-config.json |
Mermaid 렌더링 설정 |
| puppeteer-config.json | /var/www/bookstack/puppeteer-config.json |
Chromium 실행 옵션 |
중요: nvm으로 설치한 Node.js는 www-data(PHP-FPM 사용자)가 접근할 수 없다.
/usr/local/bin/node에 바이너리를 복사해야 한다.
6. 로그 확인
PDF export 시 아래 로그가 storage/logs/laravel.log에 기록된다.
정상 동작 시:
[2026-03-23] production.DEBUG: Mermaid blocks: 2
[2026-03-23] production.DEBUG: exit: 0 png exists: yes output: Generating single mermaid chart
[2026-03-23] production.DEBUG: PNG file referenced: /tmp/mmd_out_xxx.png (45231 bytes)
[2026-03-23] production.DEBUG: Cleaned up Mermaid temp file: /tmp/mmd_out_xxx.png
mmdc 실패 시:
[2026-03-23] production.DEBUG: exit: 1 png exists: no output: Error: ...
7. 브라우저 렌더링과의 관계
PDF export 파이프라인은 브라우저 렌더링과 완전히 독립적이다.
| 항목 | 브라우저 (페이지 보기) | PDF 내보내기 |
|---|---|---|
| Mermaid 로드 | mermaid-init.js (Custom HTML Head) |
mmdc CLI |
| 렌더링 엔진 | 브라우저 JS 엔진 | Puppeteer (Chromium headless) |
| 출력 형식 | SVG (인라인) | PNG (file:// 참조) |
| 뷰어 | mermaid-viewer.js (클릭 확대) |
없음 (이미지) |
| 최종 변환 | 없음 (브라우저가 직접 표시) | WeasyPrint → PDF |
| 설정 파일 | mermaid-init.js 내 initialize() |
mermaid-config.json |
브라우저 쪽 파일(mermaid-init.js, mermaid-viewer.js, mermaid-viewer.css)을
수정해도 PDF export에는 영향이 없고, 그 반대도 마찬가지다.
8. 수정 이력
| 날짜 | 파일 | 변경 내용 |
|---|---|---|
| 2026-02-23 | ExportFormatter.php |
replaceMermaidWithSvg 메서드 신규 추가 (SVG 방식) |
| 2026-03-11 | ExportFormatter.php |
SVG → PNG 전환, htmlToPdf에 try/finally 래핑 |
| 2026-03-11 | mermaid-config.json |
htmlLabels: false 제거, 기본값 사용 |
| 2026-03-23 | ExportFormatter.php |
메서드명 replaceMermaidWithSvg → replaceMermaidWithImage |
| 2026-03-23 | ExportFormatter.php |
containHtml()에 file:// 경로 가드 추가 |
9. 관련 문서
- Mermaid Part 1 ~ Part 4: 브라우저 렌더링, 에디터 프리뷰, Interactive Viewer
- Mermaid Part 5 — PDF Export PNG 전환: 이 문서의 의사결정 배경 상세
- 각주 PDF Export:
containHtml()앵커 링크 수정 - 이미지 메모리 제한:
ImageService.php50MB 제한 패치
SW 컴플라이언스 및 정책연구
오픈소스 라이선스 비교
다음 내용은 오픈소스 라이선스 관련 기본 내용 학습을 돕기위해 오픈소스 라이센스 종합정보 시스템에서 제공되는 원문 내용을 편집한 내용입니다.
ref : https://www.olis.or.kr/
오픈소스 SW의 개요
오픈소스SW는 소스코드가 공개되어 있는 SW를 말하며, 일반적으로 자유롭게 복제/배포/수정할 수 있다. 오픈소스SW의 대표적인 예로는 Linux 커널 및 아파치 웹서버, FireFox 웹브라우저, MySQL 등이 있다.
전 세계적으로 오픈소스SW는 FSF(Free Software Foundation)의 자유SW(Free Software)를 포함한 넓은 의미로 사용되고 있다. 하지만 자유SW와 오픈소스SW는 역사 및 추구하는 이념 등에서 미묘한 차이가 있다. 1980년대부터 소프트웨어가 거대 부가가치 산업으로 발전하자, 지식재산권 및 라이선스 계약을 통하여 소프트웨어의 복제, 배포, 수정에 제한을 가하려는 움직임이 나타났다. 이런 움직임에 반대하여 리처드 스톨만은 FSF를 설립하고 자유SW(Free Software) 운동을 전개하였다.
그러나 자유SW의 ‘자유(Free)’라는 단어가 일반인들에게 ‘무료’로 인식되고, 엄격한 GPL조항 때문에 상용SW개발에 이용할 수 없어 대다수 기업들이 자유SW운동에 참여하기를 꺼려하자 소스코드 공개에 보다 많은 참여를 이끌어내기 위하여 에릭 레이먼드, 브루스 페런스 등은 '오픈소스 (Open Source)' 라는 새로운 용어를 제안했다.
그리고 이러한 ‘오픈소스’는 1998년 오픈소스SW 활성화 및 오픈소스SW에 대한 인증을 담당하는 OSI (Open Source Initiative)가 결성되면서 널리 사용되기 시작했다. OSI는 오픈소스에 해당하는 라이선스의 최소한의 기준을 정의 (Open Source Definition, OSD) 해놓고 이 정의에 따라 인증, 관리 및 촉진시키는 일을 한다.
오픈소스SW의 지식재산권과 라이선스
SW 지식재산권
현재 SW는 다음과 같이 저작권, 특허권, 상표권, 영업비밀 등의 지식재산권에 의해 보호받고 있다.
저작권
저작권(copyright)은 창작물에 대하여 창작자(저작자)가 취득하는 권리로서 창작의 결과물을 보호 하며, 창작과 동시에 권리가 발생한다. 따라서 어떤 프로그래머가 특정 SW를 개발하면 컴퓨터 프로그램 저작권이 자동 발생하며, 그 권리는 프로그래머 또는 그가 속한 회사에 부여된다. 저작권이 있는 저작물의 경우 누구도 저작권자의 허락 없이는 해당 저작물을 쓸 수 없다.
특허권
특허권(patent)은 발명에 관하여 발생하는 독점적/배타적 지배권으로 법에 정해진 절차에 의해 출원을 하여야 하며, 심사를 통해 부여되는 권리이다. 특허기술을 사용하기 위해서는 반드시 특허권자의 허락을 얻어야만 한다. 특허 받은 방식을 구현하는 SW라면 프로그래밍 언어나 소스 코드와 상관없이 특허권자의 명시적인 허락을 받아야 한다
상표권
상표권(trademark right)이란 상표권자가 지정상품에 관하여 그 등록상표를 사용할 독점적인 권리로서 일정한 절차에 따라 등록하여야 효력이 발생한다. 이러한 상표를 사용하기 위해서는 반드시 상표권자의 허락을 얻어야 하며 허락받지 않고 상표를 사용할 경우 처벌을 받게 된다 상표권을 취득한 SW의 경우 상표를 사용하려면 상표권자의 명시적인 허락을 받아야 한다.
영업비밀
공개되지 않은 SW의 경우 영업비밀로서 보호를 받을 수 있으며, 공개된 SW라 하더라도 아이디어에 대한 부분은 영업비밀로 보호를 받을 수 있는 가능성이 있다. 단, 영업비밀로서의 SW보호는 널리 공개되어 유통되는 경우에는 보호받기 어렵고, 이를 알지 못하고 사용한 제3자에게 법적으로 문제를 삼을 수 없다.
라이선스 개요
라이선스의 의의
앞서 언급한 3가지에 의해 보호받으며 저작권자만이 쓸 수 있지만, 권리자가 다른 사람에게 일정한 조건으로 특정 행위를 할 수 있는 권한을 부여할 수 있다. 이와 같은 권한을 보통 '라이선스(license, 이용허락)' 라고 한다. 예를 들면 우리가 윈도우즈를 구입하면, SW권리자인 마이크로소프트로부터 윈도우즈XP를 한 대의 컴퓨터에 설치하여 이용할 수 있는 라이선스 (권리)를 받은 것에 불과하다. 그러므로 윈도우즈 정품을 구입했다고 해서 다른 사람에게 빌려주거나 복제하여 팔 수 없다.
오픈소스SW 라이선스
오픈소스SW 라이선스란 오픈소스SW 개발자와 이용자 간에 이용 방법 및 조건의 범위를 명시한 계약이다. 따라서 오픈소스SW를 이용하기 위해서는 개발자가 규정한 라이선스를 지켜야 하며, 이를 위반할 경우에는 라이선스 위반 및 저작권 침해가 발생하고, 이에 대한 책임을 지게 된다.
이런 오픈소스SW 라이선스는 기본적으로 이용자의 자유로운 사용을 보장하고 있다. 오픈소스SW가 이와 같은 라이선스를 만들어서 운영하는 이유는 오픈소스SW를 이용하여 개발한 SW에 대해서도 법의 테두리 안에서 소스코드를 공개하도록 하기 위한 것이다.
2017년 05월 현재 오픈소스SW 라이선스의 인증을 관장하고 있는 OSI에 따르면 78개가 있다. 하지만 실제로 많이 사용되는 라이선스의 개수는 한정되어 있다. 오픈소스 프로젝트 개발 포털사이트인 Freshmeat (http://freshmeat.net)에 등록된 프로젝트 약 43,722개 중 약 72%가 GPL과 LGPL 라이선스이다.
주요 라이선스
| 라이선스 이름 | 주요특징 및 배포시 의무사항 |
|---|---|
| GNU General Public License (GPLv2) | 주요 특징:소스코드는 실행물에 포함된 모든 모듈들의 소스 코드와 이와 관련된 인터페이스 정의 파일 전체, 그리고 실행물의 컴파일과 설치를 제어하는데 사용된 스크립트 전부를 의미다만, 실행물이 실행되는 운영체제의 주요 부분(컴파일러, 커널 등)과 함께 (소스 코드나 바이너리의 형태로) 일반적으로 배포되는 구성요소들은, 그 구성요소 자체가 실행물에 수반되지 않는 한 배포되는 소스 코드에 포함되지 않아도 무방서브라이선스를 허용하지 않음. 다만 제6조에 의해 수취인은 자동적으로 라이선스를 취득법원의 판결, 특허침해 등에 의해 라이선스 조건을 준수할 수 없는 경우, GPL에 의한 배포 불가능(제7조) 배포시 의무사항:각 복제본에 적절한 저작권 고지와 보증책임이 없음을 명시GPL 라이선스를 언급하는 고지사항과 보증책임 관련 고지사항을 원본 그대로 유지프로그램을 양도 받는 모든 이들에게 프로그램과 함께 GPL 라이선스 사본 제공 파일 수정의 경우 수정사실과 날짜를 파일에 명기원본저작물과 파생저작물을 GPL 2.0에 의해 배포원본저작물 및 파생저작물에 대한 소스코드를 제공하거나, 요청시 제공하겠다는 약정서 제공 |
| GNU General Public License version 3.0 (GPLv3) | 주요 특징:‘배포(distribution)’를 ‘컨베이(convey)’라는 용어로 대체복제, 수정, 배포행위 등을 포함하는 ‘프로퍼게이트(propagate)' 용어 사용‘해당 소스(corresponding source)에 인터페이스 정의 파일, 저작물의 서브프로그램과 다른 부분들 사이의 제어 흐름이나 밀접한 데이터 통신 등을 통해 저작물이 특별히 필요로 하는, 동적 링크된 하위 프로그램과 공유 라이브러리의 소스코드를 포함기술적보호조치의 보호에 관한 법적 권리의 포기(제3조)사용자제품에 대한 설치정보의 제공. “설치 정보”란 해당 소스의 수정본으로부터 발생한 사용자 제품 내의 저작물의 수정된 버전을 설치하고 실행하기 위한 모든 방법과 절차, 인증키, 기타 필요한 정보를 말함.(제6조)추가적인 허용사항 또는 제약사항을 부가하는 것을 가능하도록 함(제7조)차별적인 특허라이선스 계약체결의 금지(제11조)Affero GPL과 결합하거나 연결하여 하나의 저작물을 만들 수 있도록 허용(제13조) 배포시 의무사항 : 각 복제본에 저작권 고지와 보증책임이 없음을 명시GPL 3.0의 조건 및 제7조의 조건에 관한 내용을 있는 그대로 유지프로그램을 양도 받는 모든 이들에게 프로그램과 함께 GPL 라이선스 사본 제공수정시 수정사실 및 일시를 명시원본저작물과 파생저작물을 GPL3.0에 의해 배포원본저작물 및 파생저작물에 대한 소스코드를 제공하거나, 요청시 제공하겠다는 약정서 제공사용자제품에 대한 인증키 등 설치정보의 제공차별적인 특허라이선스 계약체결의 금지 |
| GNU Library or Lesser General Public License (LGPLv2) | 주요 특징 : LGPL 라이브러리를 이용한 응용프로그램의 경우 소스코드 제공없이 배포가능(제6조) 결합 라이브러리의 작성 허용 배포시 의무사항: 각 복제본에 적절한 저작권 고지와 보증책임이 없음을 명시 LGPL 2.1 라이선스를 언급하는 고지사항과 보증책임 관련 고지사항을 원본 그대로 유지 프로그램을 양도 받는 모든 이들에게 프로그램과 함께 LGPL 라이선스 사본 제공 라이브러리 형태로의 수정을 허용하며, 수정사실과 날짜를 파일에 명기 원본저작물과 파생저작물을 LGPL 또는 GPL에 의해 배포 원본저작물 및 파생저작물에 대한 소스코드를 제공하거나, 요청시 제공하겠다는 약정서 제공 응용프로그램을 배포할 경우, LGPL 라이브러리를 사용하고 있다는 사실을 명시 사용자가 라이브러리를 수정해도 응용프로그램을 사용할 수 있도록 (예를 들어 오브젝트코드를 제공하거나 공유라이브러리 방식 등을 이용하여) 허용 |
| GNU Library or Lesser General Public License version 3.0 (LGPLv3) | 주요 특징 : LGPL 라이브러리를 이용한 응용프로그램의 경우 소스코드 제공없이 배포가능결합라이브러리 작성의 허용(제5조)‘배포(distribution)’를 ‘컨베이(convey)’라는 용어로 대체복제, 수정, 배포행위 등을 포함하는 ‘프로퍼게이트(propagate)' 용어 사용‘해당 소스(corresponding source)에 인터페이스 정의 파일, 저작물의 서브프로그램과 다른 부분들 사이의 제어 흐름이나 밀접한 데이터 통신 등을 통해 저작물이 특별히 필요로 하는, 동적 링크된 하위 프로그램과 공유 라이브러리의 소스코드를 포함기술적보호조치의 보호에 관한 법적 권리의 포기(제3조)사용자제품에 대한 설치정보의 제공. “설치 정보”란 해당 소스의 수정본으로부터 발생한 사용자 제품 내의 저작물의 수정된 버전을 설치하고 실행하기 위한 모든 방법과 절차, 인증키, 기타 필요한 정보를 말함.(제6조)추가적인 허용사항 또는 제약사항을 부가하는 것을 가능하도록 함(제7조)차별적인 특허라이선스 계약체결의 금지(제11조)Affero GPL과 결합하거나 연결하여 하나의 저작물을 만들 수 있도록 허용(제13조) 배포시 의무사항 :각 복제본에 저작권 고지와 보증책임이 없음을 명시LGPL 3.0의 조건 및 제7조의 조건에 관한 내용을 있는 그대로 유지프로그램을 양도 받는 모든 이들에게 프로그램과 함께 GPL 및 LGPL 라이선스 사본 제공수정시 수정사실 및 일시를 명시원본저작물과 파생저작물을 LGPL3.0에 의해 배포원본저작물 및 파생저작물에 대한 소스코드를 제공하거나, 요청시 제공하겠다는 약정서 제공사용자제품에 대한 인증키 등 설치정보의 제공응용프로그램을 배포할 경우, LGPL 라이브러리를 사용하고 있다는 사실을 명시사용자가 라이브러리를 수정해도 응용프로그램을 사용할 수 있도록 (예를 들어 오브젝트코드 등을 제공하거나 공유라이브러리 방식등을 이용하여) 허용 |
| 2-clause BSD license (BSD-2-Clause) | 배포시 의무사항: 재배포시 저작권 표시, 준수조건 및 보증부인에 대한 고지사항을 소스코드 또는 문서 및 기타자료에 포함시킬 것 |
| 3-Clause BSD License(BSD-3-Clause) | 배포시 의무사항: 재배포시 저작권 표시, 준수 조건 및 보증부인에 대한 고지사항을 소스코드 또는 문서 및 기타 자료에 포함 최초개발자나 기여자의 이름을 제품에 대한 보증이나 홍보에 사용하지 못함 |
| MIT License | 주요 특징: 배포시 의무사항: 저작권 안내문구, MIT 라이선스 문구가 모든 복제본에 포함 |
| W3C License | 주요 특징: 배포시 의무사항:라이선스 전문을 재패포하거나 볼 수 있게끔 해야 함지적재산권 부인조항이나 규정, 조건 들이 존재하는 경우 이를 포함해야 하며, 이러한 사항들이 존재하지 않는 경우 다음의 사항을 포함"Copyright ⓒ [소프트웨어의 연도를 입력하라] World Wide Web Consortium, (Massachusetts Institute of Technology, Institut National de Recherche en Informatique et en Automatique, Keio University). 모든 권리를 보유함. http://www.w3.org/Consortium/Legal/"모든 변경사항이나 수정사항에 대한 고지를 포함 |
라이선스 주요내용
| 라이선스 이름 | 복제, 배포, 수정의 권한허용 | 배포시 라이선스 사본첨부 | 저작권 고지사항 또는 Attribution 고지사항 유지 | 배포시 소스코드 제공의무와 범위 | 조합저작물 작성 및 타 라이선스 배포허용 | 수정내용 고지 | 명시적 특허라이선스의 허용 | 라이선시가 특허소송 제기시 라이선스 종료 | 이름, 상표, 상호에 대한 사용제한 | 보증의 부인 | 책임의 제한 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Academic Free License | O | O | O | O | O | O | O | O | O | ||
| Adaptive Public License | O | O | O | 모듈 단위 | O | O | 선택 | 선택 | O | O | O |
| Affero GNU General Public License 3.0 | O | O | O | 네트워크 서비스 포함 전체 코드 | O | O | O | O | O | O | |
| Apache License 1.1 | O | O | 조건부 | O | O | O | |||||
| Apache License 2.0 | O | O | O | O | O | O | O | O | O | ||
| Apple Public Source License | O | O | O | 파일 단위 | O | O | O | O | O | O | O |
| Artistic License 1.0 | O | O | O | O | O | ||||||
| Artistic License 2.0 | O | O | O(표준버전) | O | O | O | O | O | O | O | |
| Attribution Assurance License | O | O | O | 조건부 | O | O | O | ||||
| Boost Software License | O | O | O | 조건부 | O | O | |||||
| Common Development and Distribution license | O | O | O | 파일 단위 | O | O | O | O | O | O | O |
| Common Public Attribution License 1.0 | O | O | O | 파일 단위 | O | O | O | O | O | O | |
| Common Public License 1.0 | O | O | O | 모듈 단위 | O | O | O | O | O | O | |
| Computer Associates Trusted Open Source License 1.1 | O | O | O | 모듈 단위 2차 저작물 | O | O | O | O | O | O | O |
| CUA Office Public License Version 1.0 | O | O | O | 파일 단위 | O | O | O | O | O | O | O |
| Eclipse Public License | O | O | O | 모듈 단위 | O | O | O | O | O | O | |
| Educational Community License | O | O | O | 조건부 | O | O | O | O | |||
| Eiffel Forum License 1.0 | O | O | O | 조건부 | O | O | |||||
| Eiffel Forum License 2.0 | O | O | 조건부 | O | O | ||||||
| Entessa Public License | O | O | 조건부 | O | O | O | |||||
| EU DataGrid Software License | O | O | 조건부 | O | O | O | |||||
| Fair License | O | O | O | ||||||||
| Frameworx License | O | O | O | O | O | O | |||||
| GNU General Public License 2.0 | O | O | O | 전체 코드 | 조건부 | O | O | ||||
| GNU General Public License 3.0 | O | O | O | 전체 코드 | O | O | O | O | O | ||
| GNU Lesser General Public License 2.0 | O | O | O | 2차 저작물 | O | O | O | O | |||
| GNU Lesser General Public License 3.0 | O | O | O | 2차 저작물 | O | O | O | O | O | O | |
| Historical Permission Notice and Disclaimer | O | O | 조건부 | O | O | ||||||
| IBM Public License | O | O | O | 모듈 단위 | O | O | O | O | O | O | |
| Intel Open Source License | O | O | 조건부 | O | O | ||||||
| ISC License | O | O | O | 조건부 | O | O | O | O | |||
| Jabber Open Source License | O | O | O | 파일 단위 | O | O | O | O | O | O | O |
| Lucent Public License(Plan9) | O | O | O | O | O | O | O | O | O | ||
| Lucent Public License 1.02 | O | O | O | O | O | O | O | O | O | ||
| Microsoft Public License | O | O | O | 조건부 | O | O | O | O | |||
| Microsoft Reciprocal License | O | O | O | 파일 단위 | O | O | O | O | O | ||
| MirOS License | O | O | O | O | O | ||||||
| MIT License | O | O | O | 조건부 | O | O | |||||
| MITRE Collaborative Virtual Workspace License | O | O | O | 조건부 | O | ||||||
| Molosoto Open Source License 0.9.1 | O | O | O | 파일단위 | O | O | O | O | O | O | O |
| Mozilla Public License 1.0 | O | O | O | 파일 단위 | O | O | O | O | O | O | O |
| Mozilla Public License 1.1 | O | O | O | 파일 단위 | O | O | O | O | O | O | |
| Multics License | O | O | O | ||||||||
| NASA Open Source Agreement 1.3 | O | O | O | 2차 저작물 | O | O | O | O | O | O | |
| Naumen Public License | O | O | 조건부 | O | O | O | |||||
| Nethack General Public License | O | O | O | O | O | ||||||
| New and Simplified BSD License | O | O | O | 조건부 | O | O | O | ||||
| Nokia Open Source License | O | O | O | 파일 단위 | O | O | O | O | O | O | |
| Non-Profit Open Software License 3.0 | O | O | 2차 저작물 | O | O | O | O | O | O | ||
| NTP License | O | O | 조건부 | O | O | ||||||
| OCLC Research Public License 2.0 | O | O | 파일 단위 | O | O | O | O | O | |||
| Open Software License | O | O | 2차 저작물 | O | O | O | O | O | O | ||
| PHP License | O | O | 조건부 | O | O | O | |||||
| Python License | O | O | O | O | O | O | |||||
| Python Software Foundation License | O | O | O | O | O | O | |||||
| RealNetworks Public Source License 1.0 | O | O | O | 파일 단위 | O | O | O | O | O | O | O |
| Reciprocal Public License 1.0 | O | O | O | 파일 단위 2차 저작물 | O | O | O | O | O | O | |
| Reciprocal Public License 1.5 | O | O | O | 파일 단위 2차 저작물 | O | O | O | O | O | O | |
| Ricoh Source Code Public License | O | O | O | 파일 단위 | O | O | O | O | O | O | O |
| Simple Public License 2.0 | O | O | O | 2차 저작물 | O | O | O | O | |||
| Sleepycat License | O | O | 동봉 SW | O | O | ||||||
| Sun Industry Standards Source License | O | O | O | 파일 단위 | O | O | O | O | O | O | |
| Sun Public License | O | O | O | 파일 단위 | O | O | O | O | O | O | O |
| Sybase Open Watcom Public License 1.0 | O | O | O | 파일 단위 | O | O | O | O | O | O | O |
| The Qt Public License | O | O | O | O | O | O | O | ||||
| University of Illinois/NCSA Open Source License | O | O | 조건부 | O | O | O | |||||
| Vovida Software License 1.0 | O | O | 조건부 | O | O | O | |||||
| W3C License | O | O | O | 조건부 | O | O | O | O | |||
| wxWindows Library License | O | O | O | 2차 저작물 | O | O | O | ||||
| The X.Net, Inc. License | O | O | O | O | |||||||
| Zlib/Libpng License | O | O | O | 조건부 | O | O | O | ||||
| Zope Public License | O | O | 조건부 | O | O | O | O |
-
※ 참고사항
-
기여자(contributor)의 범위에는 최초개발자도 포함
-
배포에서의 상호주의(Reciprociy)란
-
라이선스 적용코드를 제3자에게 배포할 때 원 라이선스와 동일한 라이선스로 배포하도록 요구하는 조항을 말하며,
-
보통 Copyleft 조항이라고도 함.
-
조합저작물(Larger Work)이란
-
라이선스 적용 코드 전체나 그 일부를 본 라이선스의 적용을 받지 않는 코드와 결합한 저작물을 의미한다.
-
빈칸은 해당 라이선스에 명시적으로 언급이 없음을 의미한다.
-
그러나 언급이 없더라도 묵시적으로 허용하거나, 금지하는 것으로 해석할 수 있으므로, 관련 전문가와 상의하기 바랍니다.
주요 오픈 라이선스의 GPL 호환성
| 오픈 소스 소프트웨어 라이선스 | GPL 2.0 호환 | GPL 3.0 호환 |
|---|---|---|
| Academic Free License | No | No |
| Affero GNU General Public License version 3.0 | No | Yes |
| Apache License version 1.0 | No | No |
| Apache License version 1.1 | No | No |
| Apache License version 2.0 | Yes | No |
| Apple Public Source License version 1.x | No | No |
| Apple Public Source License version 2.0 | No | No |
| Artistic License 1.0 | No | No |
| Clarified Artistic License (draft 2.0) | Yes | Yes |
| Artistic License 2.0 | Yes | Yes |
| Berkeley Database License | Yes | Yes |
| original BSD license | No | No |
| modified BSD license | Yes | Yes |
| Boost Software License | Yes | Yes |
| CeCILL | Yes | Yes |
| Common Development and Distribution License | No | No |
| Common Public License | No | No |
| Creative Commons licenses (Tags: by &sa) | No | No |
| Creative Commons licenses (Tags: nc &nd) | No | No |
| Cryptix General License | Yes | Yes |
| Do What The Fuck You Want To Public License (WTFPL) | Yes | Yes |
| Eclipse Public License | No | No |
| Educational Community License | No | Yes |
| Eiffel Forum License version 2 | Yes | Yes |
| Fair License | Yes | Yes |
| GNU General Public License 2.0 | Yes | No |
| GNU General Public License 3.0 | No | Yes |
| GNU Lesser General Public License | Yes | Yes |
| Hacktivismo Enhanced-Source Software License Agreement | No | No |
| IBM Public License | No | No |
| Intel Open Source License | Yes | Yes |
| ISC license | Yes | Yes |
| LaTeX Project Public License | No | No |
| Microsoft Public License | No | No |
| Microsoft Reciprocal License | No | No |
| MIT license | Yes | Yes |
| Mozilla Public License version 1.1 | No | No |
| Mozilla Public License version 2.0 | Yes | Yes |
| Netscape Public License | No | No |
| Open Software License | No | No |
| OpenSSL license | No | No |
| PHP License | No | No |
| POV-Ray-License | No | No |
| Python Software Foundation License 2.0.1, 2.1.1 and newer | Yes | Yes |
| Q Public License | No | No |
| Sun Industry Standards Source License | No | No |
| Sun Public License | No | No |
| W3C Software Notice and License | Yes | Yes |
| XFree86 1.1 License | No | Yes |
| zlib/libpng license | Yes | Yes |
| Zope Public License version 1.0 | No | No |
| Zope Public License version 2.0 | Yes | Yes |
ref
- https://www.olis.or.kr/license/introduction.do
- https://www.olis.or.kr/license/compareGuide.do
- https://www.olis.or.kr/license/distribute.do
- https://reuse.software/
오픈소스 라이선스/취약점 관리 참고자료
오소리 프로젝트
삼성전자, LG전자, 카카오는 오픈소스 소프트웨어 라이선스 정보를 10월부터 무료로 제공하기 위해 오소리 프로젝트를 구성하고 업무 협약을 체결하였다. 이는 한국저작권위원회가 각 사의 라이선스 정보를 데이터베이스로 표준화하는 작업을 통해 가능하다. 이 정보는 라이선스 명칭, 버전 정보, 사용 시 제약사항 등이 포함되어 있다. 이는 국내 소프트웨어 업계를 발전시키고 저작권 침해 위험을 줄이기 위한 노력의 일환이다.
오픈소스 종합정보 시스템
23년 부터 시작한 삼성전자·LG전자·카카오 등과 함께 오픈소스SW 라이선스 정보를 표준화해 공개하고 국내 기업이 활용할 수 있도록 무료로 제공하는 ‘오소리(Open Source DB Integration, OSORI) 오픈소스 프로젝트’ 개발이 완료되어 구축된 오픈소스 종합정보 시스템
오픈소스 취약점 대응 관련
원본 : 오픈소스 개발자의 보안전략 - 고려대학교 최윤성 교수
기존 심각도 점수를 활용한 고위험 CVE식별의 한계
- CVSS: SW 및 HW CVE의 ‘심각도(Severity)’를 평가하고 분류하는 표준 시스템
- 취약점의 잠재적 위험을 정량적으로 평가하여 ‘보안 담당자들이 취약점의 우선 순위를 효과적으로 지정’
- 취약점이 있다고 해서 반드시 해당 구성 요소가 포함된 제품에서 악용될 수 있다는 것을 의미하지는 않는 다는 점에 착안. 악용 가능성 지표를 활용한 작업 우선순위 식별. 보조지표로 EPSS 활용하여 우선순위 대응.
대응방법 취약점의 심각도 및 악용 가능성 지표를 활용한 작업 우선순위 식별
- EPSS : 향후 30일 이내에 SW 취약점이 악용될 가능성을 백분율(0-100)로 표현
- 국가 취약점 데이터베이스(NVD), CISA의 악용 사례가 알려진 취약점(KEV) 카탈로그 및 제로데이 DB 등 포함
- 차트에서 총 9,535개의 취약점 중 855개(9%)는 EPSS 수치가 높음. 악용될 가능성이 높으므로, 즉각적인 조치가 필요한 취약점으로 볼 수 있다.
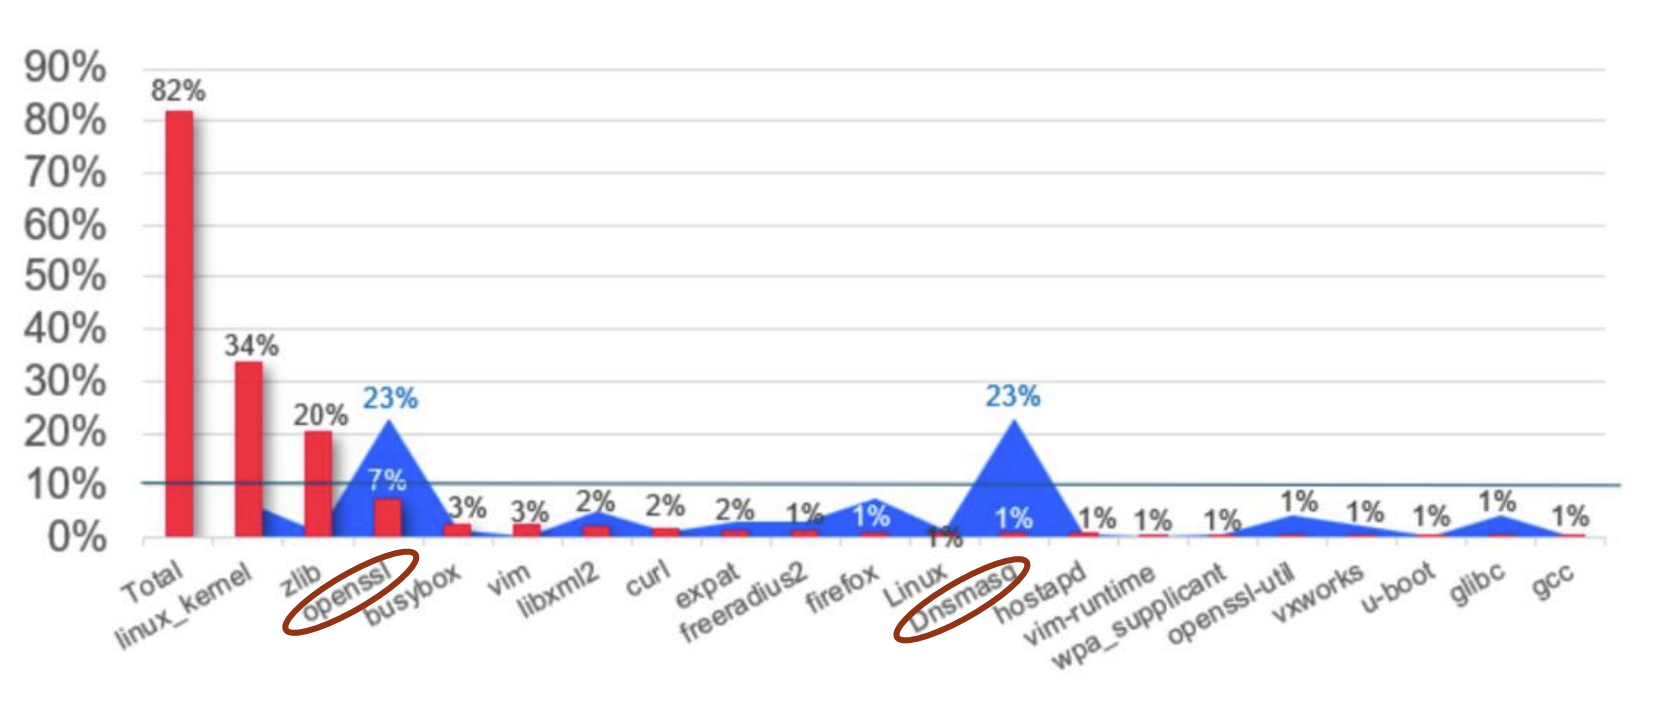
공급망 위험관리 방안
Stakeholder-Specific Vulnerability Categorization (SSVC)
- 다양한 평가 항목을 통해 취약점 조치의 우선순위를 지정하는 시스템
- 취약점 조치 관계자에게 조치 근거 제공, 상황에 맞는 솔루션을 선택적으로 적용
- 의사결정 트리(Tree)에 따른 우선 순위 작업으로 ‘작업 기한’을 결정할 수 있음
SBOM과 CVE 취약점 사이에 제로데이 및 잠재적 취약점 교집합이 존재함. 이때, 제로데이 취약점을 선제적으로 대응하고 잠재적 보안문제는 내부적으로 대응 준비를 하며 대기. 발생시 빠르게 커뮤니티를 통해 대응.
오픈소스 취약점 관련대응사례
Linux재단 OSS Securirty Global Efforts
- 다양한 오픈소스 프로젝트 보안성 점검 및 평가 (Scorecards, Pacakge Analysis)
- 신규 코드 및 갱신된 패키지의 자동 분석을 통한 악성코드 탐지 및 투명성
- 중앙집중형 악성 패키지 저장소 운영과 같은 혁신적인 방안 도입 (blacklist관리)
- 빌드시스템 개선
오픈SW 라이선스 검사도구
개요
오픈SW를 사용할 때는 라이선스 조건을 반드시 확인해야 합니다. 특히 일부 라이선스에는 3자 배포 시 소스코드 공개 의무가 포함되어 있어, 이를 준수하지 않으면 법적·기술적 문제가 발생할 수 있습니다. 따라서 오픈SW를 활용하여 개발된 기술, 제품, 서비스와 직접적으로 연관된 소스코드는 해당 조건에 따라 공개해야 합니다.
라이선스 확인 방법은 크게 두 가지가 있습니다.
-
개발자가 직접 검토: 소스코드 규모가 작을 경우, 개발자가 직접 라이선스 내용을 확인할 수 있습니다.
-
자동 검증 도구 활용: 소스코드 규모가 크거나 시간적 여유가 부족할 경우, 전용 검사 도구를 사용해 라이선스를 검증할 수 있습니다.
*주의 : 소스코드의 유사도나 일치 패턴을 중심으로 탐지하는 자동 검증 도구는 완전한 판단을 대신할 수는 없습니다. 오픈소스는 시간이 지나면서 여러 개발자에 의해 수정·재배포가 반복되므로, 단순 패턴 분석만으로는 정확한 라이선스 의무를 판별하기 어렵습니다. 따라서 도구를 활용할 때는 반드시 보조적인 수단으로 인식하고, 결과 해석에 주의를 기울여야 합니다.
검사 도구 종류
OLIS(Open Source License Information System, 오픈소스sw 라이선스 종합시스템)은 웹 상에서 손쉽게 다운받아 사용(사용 제작 재배포)하고 있는 오픈소스SW에 대해 보다 전문적인 라이선스 준수사항과 관련 국 내외 최신 정보를 한글화하여 제공함으로써 국내 오픈소스SW 사용기관 업체 및 SW개발자의 편의를 증진하고 관련 SW산업 발전을 위해 제공하는 무료 오픈소스SW 라이선스 웹 사이트입니다.
다음 도구를 통해 오픈소스 SW라이선스를 검사하는 서비스를 제공합니다.
-
CodeEye
-
Fossology
-
BAT
-
FOSSLight Hub
-
FOSSLight Source Scanner
그 외 오픈소스 검사도구
Protex : 국내 높은 점유율
- 소스 코드 비교 분석, 바이너리(기능) 비교분석 기능 제공
- Protex는 github등 다양한 오픈소스 웹사이트를 통해 이 정보를 취합하여 데이터베이스화 해둠
- 개발코드의 오픈 소스를 분석하여 Black Duck사가 데이터베이스(knowledge base)에 저장한 오픈소스와 비교
- 자동차, 임베디드, 금융, ISV, 모바일 등 다양한 분야에서 사용
https://www.blackducksoftware.com/
https://www.synopsys.com/
2025 Black Duck의 소프트웨어 보안 테스트 인사이트 및 트렌드 https://www.blackduck.com/blog/open-source-trends-ossra-report.html
ref : https://olis.or.kr/codeEye/OpensourceLicenseInsp.do
오픈소스 SW라이선스 내부교육 자료
내부 교육용 자료
개괄(추천)
https://t1.kakaocdn.net/olive/assets/opensource_guide_kakao.pdf
사내교육용 내부강의 교안(강의용)
https://openchain-project.github.io/OpenChain-KWG/guide/templates/1-policy/
AI 데이터셋과 오픈소스 컴플라이언스 관련 사례
전통적인 라이선스 컴플라이언스 문제에서 AI 생성 코드와 학습 데이터의 저작권 문제로 소송의 양상이 변화하고있다. 이에 대한 데이터 컴플라이언스와 분쟁사례를 분석해본다.
현대 AI 학습 데이터 검토의 어려움
공개되거나 알려진 LLM 구축에 사용된 데이터에 저작권을 침해한 자료가 사용되었는지 확인할 수 없는 문제.
엄청난 파라미터 사이즈를 갖는 모델들이 주류가 되면서, 학습 데이터셋 또한 완전 새로운 데이터로만 구성 된 단순 구조 형태가 아닌, 성능 향상에 필요한 다양한 오픈소스로부터 수집 된 데이터들을 복합적으로 섞은 거대한 수직 계층형 구조를 가짐.
실제로 Open Source 학습데이터를 이용하는 경우, 해당 학습데이터의 모든 원본 데이터에 대한 법적 리스크를 검토해야 하는 어려움이 존재.
최근 소송 사례
Case1. Github Copilot이 제공하는 코드 기반이 라이선스를 위반한 정책인지 여부에 대한 소송 진행중
2022년 11월, 오픈소스 저작권자들은 AI 코딩 도구인 GitHub Copilot이 허가 없이 GitHub 공개 리파지토리에서 코드를 사용하여 저작권법 및 오픈소스 라이선스에 위반한다며 OpenAI, Microsoft 및 GitHub를 상대로 저작권 집단 소송 제기
미국의 디지털 밀레니엄 저작권법 제1202조 등의 위반 및 오픈소스 라이선스 고지의무 및 공개의무 위반이라고 주장
위반 횟수에 따른 법적 손해배상액으로 환산 90억 달러(약 11조 6000억원)로 추산
OpenAI 등은 반박 의견서를 제출하며 이 소송의 각하 신청을 요청하였으나 법원은 이를 기각
2024년 7월, 판사는 원고의 대부분의 주장을 기각하여 22건 중 2건으로 청구건수를 줄임
Case2. Tremblay v. OpenAI 사건 – 학습 데이터 전체 공개 명령
-
개요
원고: 작가 Paul Tremblay, Sarah Silverman 등, 피고 : OpenAI 외
주장: OpenAI가 저작권 보호 도서를 무단 수집해 GPT-4 훈련에 사용 → 직접 저작권 침해 및 캘리포니아 부정경쟁법 위반
-
법원 명령
2025년 1월, 연방법원은 OpenAI에 대해 GPT-4 훈련에 사용된 전체 English Colang 데이터셋을 원고 측에 제공하라고 명령
-
공개되는 데이터셋의 범위
- English Colang 전체 원본 데이터셋
- 보안실 내, 인터넷 차단된 컴퓨터에서만 열람 가능, 녹음/복사 불가, OpenAI가 메모 검열 가능
-
시사점
법원이 AI 학습 데이터 자체를 저작권 침해 판단의 핵심 증거로 인정하였으며, 추후 유사 제출 명령이 반복될 경우, 기업들은 데이터 출처나 처리 절차 관리 필요 가능성이 있음
Case3. The New York Times v. OpenAI : 소스코드 및 학습 내역 공개 명령
-
소송 개요
- 원고 : 뉴욕타임즈 (NYT), 피고 : OpenAI 외
- 주장 : OpenAI와 Microsoft가 NYT 뉴스 기사를 무단 수집해 GPT를 훈련시키고, GPT가 NYT 문구를 거의 그대로 복원함 → 직접 저작권 침해 및 계약 위반
-
법원 명령
2024년 말, 법원은 GPT 훈련 내역 및 ChatGPT의 소스코드 일부에 대한 열람을 허용
-
공개되는 소스코드의 범위
- GPT 학습 내역 일부
- ChatGPT 소스코드 열람은 샌드박스 환경 내에서만 허용, 인터넷 완전 차단, 녹화·복제 금지
-
시사점 AI 소스코드조차 법원의 사법 검토 대상이 될 수 있고, 모델 생성과정 전체가 증거 개시 대상이 될 수 있음
폐쇄형/개방형 모델 개요
AI 모델별 라이선스 비교
| 항목 | 폐쇄형 AI 모델 | 개방형 AI 모델 – 오픈 Weight 모델 (Non-Permissive) | 개방형 AI 모델 – 오픈 Weight 모델 (Permissive) | 개방형 AI 모델 – 오픈소스 AI 모델 |
|---|---|---|---|---|
| 라이선스 | Proprietary License | Non-Permissive License | Permissive License | OSI 인증 오픈소스 라이선스 |
| 가중치 공개 | X | X | O | O |
| 코드 공개 | O | O | O | O |
| 데이터 공개 | X | X | Δ | O |
| 예시 공개 | Δ | Δ | O | O |
| 대표 모델 | GPT-4(OpenAI), Gemini 2.5(Google), Llama 4(Meta), Gemma 3(Google), HyperCLOVA X(네이버), EXAONE 4.0(LG) | (별도 예시 미기재) | DeepSeek R1(DeepSeek), Qwen 3(Alibaba), GPT-OSS(OpenAI) | Bloom(Bloom AI) |
LLM 모델 라이선스 현황
| 기업 | 라이선스 | 주요 내용(사실 기반) | 자유도 | |
|---|---|---|---|---|
| ChatGPT | OpenAI | Proprietary | - 사용/배포/수정 권한 제한- 상업적 이용은 OpenAI 정책에 따라 제한적 허용 | 낮음 |
| Gemini | Google/DeepMind | Proprietary | - 모델 가중치 비공개- API 기반 사용 중심 | 낮음 |
| EXAONE | LG경영개발원 | EXAONE AI Model License Agreement 1.1 / 1.2 | - 연구 목적만 사용 가능(NC)- v1.2는 교육 목적 추가 허용- 다른 모델 개발 사용 금지- 라이선서가 라이선스 변경/해지 가능 | 낮음 |
| Llama | Meta | Llama Community License Agreement | - MAU 7억 이상은 별도 라이선스 필요- 수정 모델 이름은 “Llama”로 시작해야 함- Llama 산출물의 비-Llama 모델 사용 금지 조항은 v3.1에서 삭제 | 확장제한 |
| HyperCLOVA X | 네이버 | HyperCLOVA X SEED Model License Agreement | - MAU 1000만 이상은 별도 라이선스 필요- 수정 모델 이름 시작은 “HyperCLOVA X”로 고정 | 확장제한 |
| Gemma | Google/DeepMind | Gemma Terms of Use / Prohibited Use Policy | - 사용·수정·배포·상업적 이용 허용- 배포 시 라이선스 및 이용제한 고지 의무 | 높음 |
| Qwen | 알리바바 | Tongyi Qianwen RESEARCH LICENSE → Apache 2.0 | - 초기 연구 라이선스에서 Apache 2.0으로 전환- Apache 2.0은 완전한 Permissive | 높음 |
| DeepSeek | DeepSeek | DeepSeek License Agreement → MIT | - MIT 기반 완전한 Permissive | 높음 |
| DeepSeeK | Linux Foundation | OpenMDW License Agreement 1.0 | - 머신러닝 모델용 Permissive 라이선스(2025.5 발표)- “Model Materials” 정의: 모델·데이터·문서·SW 포함- 저작권·특허·DB·영업비밀 권리 부여- 배포 시 고지 의무·특허보복 조항 외 제한 없음 | 높음 |
기업 대응 사례 참고
LG EXAONE
- 데이터셋의 정보를 바탕으로 어떤 하위 데이터 소스로 데이터셋이 구성되어 있는지, 각 데이터 셋의 라이선스 정보가 어떻게 되는지를 자동적으로 탐색
- 사용하고자 하는 단일 데이터 셋이 아닌, 데이터 셋이 갖고 있는 모든 출처가 되는 데이터 셋의 법적 위험을 Data의 Life Cycle 측면에서 탐지
- 상업적으로 이용 가능하다고 판단된 2,852개의 AI 학습 데이터셋 중 종속 데이터의 리스크를 모두 고려해 본 결과, 21.21%인 605개의 데이터셋만 상업적으로 이용 가능했음.
- 법률적 검토과정에서 EXAONE NEXUS를 이용해 인간 변호사와 비교했을 때 45배 빠른 속도, 0.1% 수준의 비용, 26% 빠른 정확도로 검출
- 최종 검토는 인간 변호사 검토.
전자정부 프레임워크 5.0 (Beta) 표준사양서
전자정부 표준프레임워크 v5.0 표준 사양 요약
| 구분 | 주요 특징 및 역할 | 핵심 기술 스펙 (v5.0 Beta 기준) | 참조 URL |
|---|---|---|---|
| 실행 환경 (Execution) | 애플리케이션 실행을 위한 핵심 프레임워크 및 라이브러리 제공 | - Spring Boot 3.5.6 - Spring Framework 6.2.11 - Jakarta EE 10 적용 - Java 17 이상 필수 (Java 21 권장) |
바로가기 |
| 개발 환경 (Development) | 개발 생산성 향상을 위한 IDE 및 도구(프로젝트 생성, 코드 생성 등) | - Eclipse 2025-03 (4.35) - VS Code Extension 5.0.0 출시 - AI 기반 프로젝트/CRUD 코드 생성 지원 - GitHub Copilot 연동 가이드 제공 |
바로가기 |
| 운영 환경 (Operation) | 클라우드 네이티브 환경에서의 서비스 메시 및 관찰 가능성(Monitoring) 제공 | - Kubernetes v1.32.5 / Istio v1.25.3 - OpenTelemetry 기반 관찰성 도구 - Prometheus, Grafana, Loki, Jaeger 포함 |
바로가기 |
| 모바일 환경 (Mobile) | 모바일 앱 및 웹 개발을 위한 Flutter 기반의 환경 및 API 제공 | - Flutter 기반 전면 전환 (기존 하이브리드 대체) - 디바이스 API 9종 (가이드 프로그램 포함) - KRDS(국가 서비스 디자인 가이드) 반영 |
바로가기 |
전자정부 표준프레임워크 4.x → 5.0 마이그레이션 영향도 분석
| 구분 | 4.x 버전 사양 | 5.0 (Beta) 버전 사양 | 마이그레이션 영향도 및 조치 사항 |
|---|---|---|---|
| JDK 버전 | Java 8 또는 11 | Java 17 이상 (21 권장) | [매우 높음] 최소 사양이 Java 17로 상향됨에 따라 인프라 및 컴파일 환경 업그레이드 필수 |
| Java EE 사양 | Java EE (javax.*) | Jakarta EE 10 (jakarta.*) | [매우 높음] 서블릿, JPA 등 모든 패키지명이 javax에서 jakarta로 변경됨. 전체 소스 코드의 import 구문 수정 필요 |
| Spring Framework | 5.3.x | 6.2.11 | [높음] Spring 6의 변경된 설정 방식 및 제거된 클래스(예: WebSecurityConfigurerAdapter 등) 대응 필요 |
| Spring Boot | 2.7.x | 3.5.6 | [높음] Spring Boot 3 기반 설정 방식(Auto Configuration 등)으로의 마이그레이션 필요 |
| Persistence (DB) | Hibernate 5.6 / MyBatis 3.5.x | Hibernate 6.6 / MyBatis 3.5.19 | [중간] Hibernate 6의 Query 방식 변경 대응 및 DB 드라이버 호환성 체크 필요 |
| 개발 도구 (IDE) | Eclipse 2022-12 이하 | Eclipse 2025-03 / VS Code | [중간] 최신 이클립스 사용 필수. VS Code 사용 시 전용 확장 프로그램 설치 권장 |
| 모바일 기술 | Hybrid (PhoneGap/Cordova) | Flutter (Native-like) | [매우 높음] 기존 하이브리드 소스 재사용 불가. Dart 언어 기반 Flutter로 전면 재개발 필요 |
| 운영/배포 | WAS 중심 배포 | Cloud Native (k8s/Istio) | [중간] 컨테이너 기반 운영 시 OpenTelemetry 및 서비스 메시(Istio) 설정 반영 필요 |
v5.0 핵심 변경 및 기술문서 작성 가이드
1. 언어 및 사양 현대화 (실행환경/개발환경)
- Java 17(최소 실행환경) 도입과 Jakarta EE 10 전환은 기술문서 작성 시 중요한 변경 사항입니다. 기존
javax.*패키지가jakarta.*로 변경되는 내용을 기술 가이드에 반드시 명시해야 합니다.
2. 멀티 IDE 지원 (개발환경)
- 기존 이클립스 단일 체제에서 VS Code 확장 프로그램까지 공식 지원 범위가 확대되었습니다. 개발 환경 구축 섹션에서 이클립스 설치형과 VS Code 플러그인형을 구분하여 기술할 수 있습니다.
3. 클라우드 네이티브 운영 강화 (운영환경)
- 단순 배포를 넘어 클라우드서비스 메시(Kubernetes v1.32.5, Istio v1.25.3), 모니터링 도구 (OpenTelemetry v0.120.0, Prometheus, Grafana, Loki, Jaeger, Kiali, Tempo 포함)가 표준 사양으로 들어왔습니다.
- 이는 MSA(마이크로서비스 아키텍처) 기반 프로젝트 시 운영 가이드의 핵심이 됩니다.
4. Flutter 기반 개발 (모바일)
- PhoneGap/Cordova 기반의 하이브리드 방식에서 벗어나 Flutter 기반의 네이티브급 개발 방식으로 기술 스택이 전면 개편되었습니다. 모바일 프로젝트 시 개발 언어를 Dart/Flutter로 정의해야 합니다.
- KRDS 디자인 리소스 반영여부를 포함하여야합니다.
5. AI 연동 기능 활용법 (공통)
- v5.0은 AI 템플릿(RAG 등) 과 Spring AI 활용이 포함되어 있습니다.
Reference
전자정부프레임워크 : https://www.egovframe.go.kr/home/sub.do?menuNo=39
발표영상 : https://youtu.be/crkDU3O7uf8?t=2333
AI-Gen 관련 영상 : https://youtu.be/crkDU3O7uf8?t=4451
국가AI전략위 문서작성 체계 혁신화
국가AI전략위, 문서 작성 체계 혁신으로 AI 활용 기반 강화한다
출처: 국가인공지능전략위원회 보도자료
보도일: 2026.3.6.(금) 09:00
담당: 총괄전략팀 김보경 팀장 (02-2224-4121), 홍현욱 전문관 (02-2224-4127)
핵심 요약
국가인공지능전략위원회(위원장: 이재명 대통령)는 분과별 회의 및 토론 결과를 마크다운(Markdown, .md) 형식으로 작성·관리하고, 위원회 누리집(www.aikorea.go.kr)을 통해 공개할 계획을 발표했다.
배경: 왜 마크다운인가
기존 한글 문서의 문제점
- 사람이 눈으로 보는 시각적 표현에 초점을 두고 작성됨
- 글꼴·자간·기호표 등 다양한 편집이 적용되어 있어 AI가 문장과 문단 구조를 정확히 인식하기 어려움
- AI 학습과 활용에 불편하다는 문제의식이 지속 제기
마크다운의 장점
- 복잡한 서식 없이 제목·문단·목차 등 문서 구조를 단순한 기호로 표현
- 사람과 AI가 함께 읽기 쉬운 문서 형식
- 국제적으로 널리 사용되며 AI 학습에 주로 활용되는 표준 형식
주요 내용
전환 대상
위원회의 회의 및 토론 결과 문서를 마크다운 형식으로 작성·관리한다.
기대 효과
- 고품질 정책 데이터 축적 — 공적 의사결정이 기록된 문서가 AI의 한국어 이해 능력을 높이는 자산으로 활용
- 민간 AI 생태계 활성화 — 축적된 정책 데이터를 기업이 AI 모델 개발과 서비스 혁신에 직접 활용 가능
- 정부 업무 방식 혁신 — 정책이 축적·관리되는 방식 자체를 혁신하는 출발점
공개 방식
- 위원회 누리집 게시판에서 마크다운 원문 복사 및 다운로드 기능 제공
.md파일 형태로 직접 다운로드 가능
주요 인용
임문영 상근 부위원장:
"AI 시대에는 정책 내용뿐 아니라 정책이 축적·관리되는 방식을 혁신하는 것 자체가 중요하다. 이번 문서 체계 전환은 정부가 AI를 활용하는 방식과 일하는 문화를 바꾸는 출발점이 될 것."
참고: 마크다운 적용 예시
위원회 누리집에서는 아래와 같은 형태로 회의록을 마크다운으로 작성·표현한다.
# [회의명] 00회의록

- 일시: 2026.01.27.(화) 14:00~15:30
- 장소: 국가인공지능전략위원회 지원단 ○○회의실
- 참석자: ○○부, ○○부, 민간위원 등

## 회의 목적

- AI 기본법 시행('26.1.22)에 따른 후속조치 점검
- AI 액션플랜 이행 현황 공유

---

## 안건 1. AI 기본법 시행령 추진 현황

### 논의 요지

- 시행령 초안은 관계부처 협의 단계
- 일부 조항에서 부처 간 해석 차이 존재

### 주요 발언

- ○○부: "상반기 내 확정 필요"
- ○○위: "조항 명확화 필요"

### 결정사항

- 쟁점 정리본을 별도 문서로 작성하여 공유

### 후속조치

- (○○부) 쟁점 정리본 작성 → 2.5.(월)
- (지원단) 부처 의견 취합 → 2.8.(목)
시사점
- 정부 차원에서 마크다운을 공식 문서 형식으로 채택한 첫 사례
- 공공 정책 데이터의 AI 활용 가능성을 열어주는 방향
- 사내 문서 작성 체계(예: BookStack 등)에서 마크다운 기반 문서작성 지속성 보장
보도자료 원본 : (260305)+국가AI전략위,+문서+작성+체계+혁신으로AI+활용+기반+강화한다(최종).pdf
2026년 국가 AI데이터센터 고도화사업 — 이용자 정기모집 신청 가이드
공고기관: 인공지능산업융합사업단(AICA)
신청기간: 2026. 4. 1.(수) ~ 4. 22.(수) 14:00
신청시스템: AIMS (aidc.atops.or.kr)
문의: 062-610-4019 / aica_dc@aicluster.or.kr
설명회: 4. 10.(금) 14:00 온라인 줌 (사전신청, 마감 4. 9. 17:00)
참고 : 2026년 국가 AI데이터센터 고도화 사업 이용자 정기모집 공고문.pdf
1. 지원 대상 및 제한
| 구분 | 지원 대상 | 지원 기준 | 비고 |
|---|---|---|---|
| 1 | 국내기업 | 기업당 2건 지원 | 사업자등록증 등 |
| 2 | 대학교(원) | 과·부별 2건 지원 | 재직증명서 등 |
| 3 | 공공기관, 연구소(원), 협·단체 | 부서별 2건 지원 | 재직증명서 등 |
제외 대상: 소속 없는 개인, 대기업, 정부사업 참여제한 제재 중인 기관, '25년 만족도·성과조사 미응답 기관
중복 제한: 유사사업(NIPA 고성능컴퓨팅, NIPA 첨단GPU 등) 포함 '26년 총 2건까지. 초과 선정 시 제외.
2. 트랙별 자원 구성
| 순번 | 구분 | 지원 구분 | 지원기간 |
|---|---|---|---|
| 1 | 1트랙 | H100 | 협약체결일 ~ '26.12월 |
| 2 | 2트랙 | B200 또는 B300 | 협약체결일 ~ '26.12월 |
| 3 | 3트랙 | HPC | 협약체결일 ~ '26.8월 |
| 구분 | 자원타입 | 구성방식 | 모집비율 |
|---|---|---|---|
| 1트랙 | H100 8장 | 고정 및 동적할당 | 약 40% 내외 |
| 2트랙 | B200 또는 B300 8장 | 고정 및 동적할당 | 약 40% 내외 |
| 3트랙 | HPC 최대 6PF (1~6PF) | 고정 및 동적할당 | 약 20% 내외 |
모집규모: 약 45개사 내외. 정책지원·자원회수·대기풀 현황에 따라 변경 가능.
자원타입(예: B200→B300) 및 지원건수는 정부예산·공급사 선정 결과에 따라 변동 가능.
3. 기업분담금
| 구분 | 가속기 | 기업분담금 | 할인 적용(50%) | 비고 |
|---|---|---|---|---|
| 1트랙 | H100 | 40만원/1장 | 20만원/1장 | |
| 2트랙 | B200 또는 B300 | 80만원/1장 | 40만원/1장 | |
| 3트랙 | HPC (1~6PF) | 40만원/1장 | 20만원/1장 | H100 기준 |
| 구분 | 할인 대상 | 할인율 |
|---|---|---|
| 1 | 청년기업 | 50% |
| 2 | 지역기업(관) | 50% |
- 납부 시점: 협약체결 후 15일 이내, 분기별(90일) 또는 연납 선납
- 미납 시: 선정 대상에서 제외 가능
- 환불: 중도 포기 시 미사용 잔액에 한해 환불 가능. 부정행위 회수 시 반환 불가.
4. 제출 서류
| 구분 | 제출서류 | 필수여부 | 해당사항 |
|---|---|---|---|
| 1 | 이용신청서 및 계획서 | 필수 | 공통 |
| 2 | 과제책임자 및 과제신청 개별 동의서 | 필수 | 공통 |
| 3-1 | 사업자등록증 (기업/소속대학 등 신청기준) | 필수 | 공통 |
| 3-2 | 과제책임자 재직증명서 | 필수 | 공통 |
| 3-3 | 중견/중소/벤처/창업기업 확인서 | 해당시 필수 | 기업(산) |
| 4-1 | 법인등기부등본 또는 신분증사본 등 | 해당시 필수 | 청년기업 |
| 4-2 | 사업자등록증 (본점기준) | 해당시 필수 | 지역소재 기업·관 |
서류 작성 필수 확인사항
- 서류 1건이라도 미비하면 별도 보완요청 없이 서류 미선정(탈락) 처리
- 과제책임자 / 실무담당자는 반드시 상이한 인물이어야 함
- 시스템(AIMS) 입력 내역, 이용신청서, 증빙서류 정보가 모두 일치해야 함
- 증빙서류는 공고일 기준 최근 3개월 이내 (2026. 1월 이후) 발급분만 인정
- 재직증명서에 부서명/과명 포함 필수
- 주민등록번호 뒷자리 마스킹 처리 필수
- 중소이면서 벤처인 경우 확인서 두 가지 모두 제출
- 과제책임자 서명 후 제출
5. 신청 방법
AIMS(aidc.atops.or.kr) 접속
  → 회원가입 및 로그인 (과제책임자·신청자 모두 사전 가입 필수)
    → 공고신청 – 공고조회
      → 신청서류 작성 및 접수
        → 신청완료
- 마감: 4. 22.(수) 14:00 — 이후 추가접수 불가
- 마감 당일 접수 집중 예상, 사전 신청 권고
- 중복신청 확인 시 최초 접수건만 인정 (변경은 마감일 전 유선/메일로 요청)
- 시스템 이용 매뉴얼 사전 확인 필수
6. 선정 절차 및 일정
| 절차 | 내용 | 일정 |
|---|---|---|
| 모집 공고 | 신청서/계획서 및 관련 서류 제출 | '26.4월 |
| 선정평가 | 서류 적격검토 + 외부전문위원회 평가 | '26.5월 초 |
| 결과통보 | AIMS 결과 안내 | '26.5월 초 |
| 협약 체결 | 협약 체결 및 확인 | 결과통보 후 1주일 이내 |
| 기업분담금 납부 | 납부 및 확인 | 협약체결 후 2주일 이내 |
| 자원할당 | 자원할당, 환경세팅 등 | 납부완료 후 1주일 이내 |
| 사전 교육 | 자료 배포 및 온라인 사전교육 | '26.5월 |
7. 평가 항목 및 배점
| 평가항목 | 세부항목 | 배점 |
|---|---|---|
| 필요성 | 고성능 컴퓨팅 자원의 필요성 및 당위성 / 사업 목적·추진방향 부합성 | 20 |
| 수행과제 우수성 | 참여인력 전문성·이용계획 명확성 / 관련 연구개발 실적 | 30 |
| 컴퓨팅자원 활용 가능성 | 즉시 이용 가능성 / 추진방법·일정 타당성·현실성 / AI모델 우수성·구현 현실성 (과제 사이즈 적정성 포함) | 30 |
| 목표성과 및 창출효과 | 목표성과 구체성·달성가능성 / 매출·고용효과 / 사업성·시장 파급효과 | 20 |
| 합계 | 100 |
선정 기준: 평점 70점 이상 과제 중 고득점순으로 자원 할당. 필수서류 미제출 시 서류평가 탈락.
가산점
| 항목 | 조건 | 가산점 |
|---|---|---|
| 우수이용자(2025년) | 2025년 우수 이용자 선정 | 2점 |
| 청년기업 | 대표자 만 39세 이하 (1986.04.02. 이후 출생) | 2점 |
| 지역기업(관) | 본점 소재지·신청지가 수도권 제외 지역 | 2점 |
중복 가산 가능 (최대 6점). 증빙서류 미제출 시 해당되더라도 미인정.
3트랙(HPC) 발표평가
1·2트랙은 서류/서면평가만 진행. 3트랙은 발표평가 추가.
| 항목 | 내용 |
|---|---|
| 방식 | 온라인 평가 |
| 발표자 | 과제책임자 또는 실무담당자 |
| 자료 | PPT |
| 시간 | 총 20분 (발표 10분 + 질의응답 10분) |
| 예정일 | '26. 5월 2주 중 (대상자 별도 공지) |
| 미참석 시 | 최종 선정 제외 가능 |
8. 선정 후 의무사항
| 의무 | 내용 | 미이행 시 |
|---|---|---|
| 사전교육 | 최소 1인 이상 의무 참석 | 자원 회수 가능 |
| 이용률 유지 | 주기적 평균 이용률 점검 | 자원 조정·회수 |
| 목적 내 사용 | 제안 과제 외 사용 금지 (채굴, GPU Burn 등) | 즉시 회수 + 당해연도 재신청 불가 |
| 성과보고서 | 학습모델, 논문, 특허, SW개발, 매출, 채용 등 증빙 제출 | 자원 회수 또는 차년도 참여 제한 |
| 만족도조사 | 연 1회 이상 응답 필수 | 차년도 지원 대상 제외 가능 |
- 자원조정 시 데이터 백업기간 7일 별도 제공
- 서비스 종료 후 1개월간 무상 백업 지원
- 자진반납 가능 (종료 15일 전 신청)
9. 신청 전 최종 체크리스트
자격
인력
서류
시스템
가산점 (해당 시)
부록 A. 신청 자격 세부 기준
| 순번 | 구분 | 지원대상 | 지원자격 | 증빙서류 |
|---|---|---|---|---|
| 1 | 국내기업(산) — 중견/중소·벤처 | 중견·중소·벤처기업 확인서를 발급받을 수 있는 법인 또는 개인사업자 | [중견] 중견기업 확인서 / [중소] 중소기업 확인서 / [벤처] 벤처기업 확인서. 청년기업은 법인등기부등본 추가(개인사업자는 신분증사본) | |
| 2 | 국내기업(산) — 창업기업 | 중소기업을 창업하여 사업 개시일로부터 7년 미경과 기업 | 중소/벤처 확인서 발급 불가 시 사업자등록증. 청년기업은 법인등기부등본 추가 | |
| 3 | 대학(학) — 대학교(원) | 대학교(원)에 재직 중인 자 | 재직증명서 | |
| 4 | 대학(학) — 대학병원 | 대학병원에 재직 중인 자 | 재직증명서 | |
| 5 | 기관(연) — 공공기관 | 공공기관의 운영에 관한 법률 제4조 1항 각호 해당 기관 | 사업자등록증 | |
| 6 | 기관(연) — 연구소(원) | 정부 지원 또는 공공 목적으로 설립·운영되는 연구기관 | 사업자등록증 | |
| 7 | 기관(연) — 협·단체 | 국내 소재 협·단체(사단법인, 협회 등) | 사업자등록증 |
청년기업 기준: 대표자(공동대표 중 1인 이상)가 공고일 기준 만 39세 이하 (1986.04.02. 이후 출생자). 법인은 법인등기부등본, 개인사업자는 생년월일 표기 신분증사본 제출.
부록 B. 트랙 선택 가이드 및 개발환경 사양
트랙별 적합 용도
| 트랙 | 적합 시나리오 | 유의사항 |
|---|---|---|
| 1트랙 (H100) | 중규모 파인튜닝, 추론 서비스, LoRA 등 경량 학습. 기존 H100 최적화 코드 보유 시 최적 | SW 생태계 성숙도 높음, 호환성 리스크 낮음 |
| 2트랙 (B200/B300) | 대형 모델 학습, FP4/FP8 고성능 연산 필요 과제. B300은 288GB HBM3e로 대모델 단일노드 학습 가능 | Blackwell 아키텍처 초기 단계 — 일부 라이브러리 최적화 미성숙 가능 |
| 3트랙 (HPC) | 수천억 파라미터급 사전학습(Pre-training), 대규모 분산학습 | 지원 기간 짧음(~8월). 발표평가 추가. 평가 기준 엄격 |
개발환경 사양
| 구분 | 1트랙 (H100) | 2트랙 (B200/B300) | 3트랙 (HPC) |
|---|---|---|---|
| 운영체제 | Ubuntu 22.04 LTS(64) 이상 | Ubuntu 22.04 LTS(64) 이상 | Ubuntu 22.04 LTS(64) 이상 |
| TensorFlow | 2.14.0 이상 | 2.14.0 이상 | 2.14.0 이상 |
| PyTorch | 2.3.0 이상 | 2.3.0 이상 | 2.3.0 이상 |
| Python | 3.10 이상 | 3.10 이상 | 3.08 이상 |
| CUDA | 12.3 이상 | 12.3 이상 | 11.8 이상 |
| NVIDIA 드라이버 | 535.161.00 이상 | 535.161.00 이상 | 535.161.08 이상 |
| 스토리지 | SSD 10TB | SSD 10TB | SSD 10TB |
| 보안 | DDoS, IDS, SIEM | DDoS, IDS, SIEM | DDoS, IDS, SIEM |
3트랙의 CUDA(11.8)·Python(3.08) 버전이 1·2트랙과 상이. 최종 자원할당 시 세부 사양 안내 예정.
부록 C. 기업분담금 할인 적용 기준
1. 청년기업
대표자(공동대표인 경우 1인 이상)가 공고일 기준 만 39세 이하.
2. 지역기업(관)
공고일 이전 사업장 본점 소재지 및 신청지가 수도권(서울, 경기, 인천) 제외 지역. AICA 실증창업동 입주기업 포함.
납부 흐름:
협약체결 → 사업단이 기업분담금 통보 → 기한 내 지정 계좌(공급사 등) 납부 → 자원 할당
부록 D. 서류별 작성 요령
| 구분 | 서류 | 작성 요령 |
|---|---|---|
| 1 | 이용신청서 및 계획서 | 평가에 반영되므로 구체적 작성. 과제책임자/실무담당자 정보를 시스템·신청서·증빙 모두 일치시킬 것. 과제책임자 서명 필수. |
| 2-1 | 과제책임자 동의서 | 동의 내역 확인 후 동의여부 체크. 과제책임자 작성·서명. (개인정보·과제정보 제공동의서 + 자원이용과제 동의서) |
| 2-2 | 실무담당자 동의서 | 동의 내역 확인 후 동의여부 체크. 실무담당자 작성·서명. (개인정보·과제정보 제공동의서) |
| 3-1 | 사업자등록증 | 대학: 소속대학 또는 산학협력단 사업자등록증. 신청 기준으로 제출. |
| 3-2 | 재직증명서 | 부서명/과명 포함 필수. 신청내용과 일치 확인. |
| 3-3 | 기업 확인서 | 중소이면서 벤처인 경우 두 가지 모두 제출. |
| 4-1 | 법인등기부등본/신분증 | 청년기업: 법인→법인등기부등본, 개인사업자→생년월일 표기 신분증사본. |
| 4-2 | 본점 사업자등록증 | 지역소재 기업·관 해당 시 제출. |
부록 E. 계획서 작성 전략
각 평가항목별로 계획서에서 다루어야 할 핵심 포인트:
필요성 (20점)
고성능 GPU가 필요한 기술적 근거. 자체 인프라로 불가능한 이유. 사업 목적·추진방향과의 정합성.
수행과제 우수성 (30점)
참여 인력의 AI 분야 전문성(학위, 논문, 프로젝트)과 기관의 관련 R&D 실적. 이용 계획의 명확성과 실현 가능성.
컴퓨팅 자원 활용 가능성 (30점) — 최대 배점
핵심은 "환경 세팅(최대 2주) 후 즉시 이용 가능"의 증명. AI 모델/데이터 확보 현황, 추진 일정의 현실성, 과제 규모 대비 GPU 수량 적정성.
목표성과 및 창출효과 (20점)
논문, 특허, 상용화 서비스, 매출 증대, 신규 채용 등 정량적 목표. 기술의 사업성과 시장 파급효과.
부록 F. 사업 배경 — 국가 GPU 인프라 확충 맥락
이 사업은 정부가 확보한 국가 GPU 자원 위에서 이용자를 선발하는 구조다. 2025년 1차 추경 1.46조 원으로 H200·B200 등 13,000장을 확보했고, 2026년 본예산 약 2조 원으로 15,000장 이상 추가 확보를 진행 중이다.
2트랙에 B200/B300이 포함된 것은 H100→Blackwell 세대 전환을 반영한다. 2026년 하반기 NVIDIA Vera Rubin(VR200)의 데이터센터 배치가 예정되어 있어, 향후 사업에서는 차세대 아키텍처 비중이 확대될 전망이다.
2026. 4. 12. 기준 공고문 및 공개 보도자료 기반. 세부사항 변경 가능성이 있으므로 AIMS(aidc.atops.or.kr) 및 AICA(www.aica-gj.kr)에서 최신 공고 확인바랍니다.
Practical Mermaid v11 실무 다이어그램 쿡북 테스트
프로그래머를 위한 실전 응용 사례 모음 만들기
1. CI/CD 파이프라인 — GitHub Actions 기반 배포 플로우
실제 모노레포 프로젝트의 CI/CD 파이프라인을 flowchart로 표현한 예시. subgraph 중첩, 조건 분기, 스타일링을 활용합니다.
flowchart TD
    trigger["🔔 Push / PR to main"]
    trigger --> lint_check

    subgraph CI["CI Pipeline"]
        direction TB
        lint_check["ESLint + Prettier Check"]
        type_check["TypeScript tsc --noEmit"]
        unit_test["Unit Tests (Vitest)"]
        integration["Integration Tests (Playwright)"]
        build["Build Artifacts"]

        lint_check --> type_check
        type_check --> unit_test
        unit_test --> integration
        integration --> build
    end

    build --> is_main{main branch?}

    is_main -- "Yes" --> staging_deploy
    is_main -- "No (PR)" --> preview_deploy

    subgraph CD_Preview["Preview Environment"]
        preview_deploy["Deploy to Vercel Preview"]
        preview_url["Generate Preview URL"]
        preview_comment["Comment PR with URL"]
        preview_deploy --> preview_url --> preview_comment
    end

    subgraph CD_Staging["Staging → Production"]
        staging_deploy["Deploy to Staging (k8s)"]
        smoke_test["Smoke Tests"]
        approval{Manual Approval?}
        canary["Canary Deploy (10%)"]
        monitor["Monitor Error Rate (15min)"]
        error_check{Error Rate < 0.1%?}
        full_rollout["Full Rollout (100%)"]
        rollback["🔴 Rollback"]
        notify_slack["Notify Slack #deploy"]

        staging_deploy --> smoke_test
        smoke_test --> approval
        approval -- "Approved" --> canary
        approval -- "Rejected" --> rollback
        canary --> monitor --> error_check
        error_check -- "Pass" --> full_rollout --> notify_slack
        error_check -- "Fail" --> rollback --> notify_slack
    end

    style trigger fill:#4A90D9,color:#fff
    style rollback fill:#E74C3C,color:#fff
    style full_rollout fill:#2ECC71,color:#fff
    style notify_slack fill:#611f69,color:#fff
2. 마이크로서비스 Sequence Diagram — 주문 처리 흐름
실제 이커머스 마이크로서비스 아키텍처에서 주문이 처리되는 과정. 비동기 메시지, 에러 처리(alt), 병렬 처리(par)를 모두 활용합니다.
sequenceDiagram
    actor User
    participant GW as API Gateway
    participant Auth as Auth Service
    participant Order as Order Service
    participant Inv as Inventory Service
    participant Pay as Payment Service
    participant MQ as Message Queue (Kafka)
    participant Notify as Notification Service
    participant Ship as Shipping Service

    User ->>+ GW: POST /orders (JWT)
    GW ->>+ Auth: Validate Token
    Auth -->>- GW: ✓ Valid (userId: 42)

    GW ->>+ Order: CreateOrder(items, userId)
    Order ->>+ Inv: ReserveStock(items)

    alt Stock Available
        Inv -->>- Order: Reserved (reservationId: R-001)
        Order ->>+ Pay: ChargePayment(amount, paymentMethod)

        alt Payment Success
            Pay -->>- Order: Charged (txId: TX-9876)
            Order ->> Order: Status → CONFIRMED

            par Async Notifications
                Order -)+ MQ: OrderConfirmed Event
                MQ -)+ Notify: Consume Event
                Notify --) User: 📧 Order Confirmation Email
                Notify --) User: 📱 Push Notification
                deactivate Notify
            and Fulfillment
                MQ -)+ Ship: Consume Event
                Ship ->> Ship: Create Shipping Label
                Ship -->>- MQ: ShipmentCreated Event
                deactivate MQ
            end

            Order -->>- GW: 201 Created {orderId: ORD-5678}
        else Payment Failed
            Pay -->> Order: ❌ Declined (reason: insufficient_funds)
            Order ->> Inv: ReleaseStock(R-001)
            Inv -->> Order: Released
            Order -->> GW: 402 Payment Required
        end
    else Out of Stock
        Inv -->> Order: ❌ Unavailable (item: SKU-123)
        Order -->> GW: 409 Conflict (out_of_stock)
    end

    GW -->>- User: Response
3. Entity-Relationship Diagram — SaaS 멀티테넌트 스키마
실제 B2B SaaS 제품의 멀티테넌트 데이터 모델.
erDiagram
    TENANT ||--o{ USER : has
    TENANT ||--o{ WORKSPACE : owns
    TENANT ||--|| SUBSCRIPTION : subscribes
    TENANT {
        uuid id PK
        string name
        string slug UK
        string plan_tier "free|pro|enterprise"
        timestamp created_at
        jsonb settings
    }

    USER ||--o{ WORKSPACE_MEMBER : "joins"
    USER ||--o{ API_KEY : generates
    USER ||--o{ AUDIT_LOG : creates
    USER {
        uuid id PK
        uuid tenant_id FK
        string email UK
        string password_hash
        enum role "owner|admin|member"
        boolean mfa_enabled
        timestamp last_login_at
    }

    WORKSPACE ||--o{ PROJECT : contains
    WORKSPACE ||--o{ WORKSPACE_MEMBER : "has members"
    WORKSPACE {
        uuid id PK
        uuid tenant_id FK
        string name
        text description
        jsonb settings
    }

    WORKSPACE_MEMBER {
        uuid workspace_id FK
        uuid user_id FK
        enum role "admin|editor|viewer"
        timestamp joined_at
    }

    PROJECT ||--o{ ISSUE : tracks
    PROJECT ||--o{ LABEL : defines
    PROJECT ||--o{ MILESTONE : plans
    PROJECT {
        uuid id PK
        uuid workspace_id FK
        string key "e.g. PROJ"
        string name
        integer issue_counter
        enum status "active|archived"
    }

    ISSUE ||--o{ COMMENT : has
    ISSUE ||--o{ ISSUE_LABEL : tagged
    ISSUE }o--o| MILESTONE : "assigned to"
    ISSUE }o--o| USER : "assigned to"
    ISSUE {
        uuid id PK
        uuid project_id FK
        integer number
        string title
        text body_markdown
        enum priority "urgent|high|medium|low"
        enum status "backlog|todo|in_progress|done|cancelled"
        uuid assignee_id FK
        uuid reporter_id FK
        timestamp due_date
    }

    SUBSCRIPTION ||--o{ INVOICE : generates
    SUBSCRIPTION {
        uuid id PK
        uuid tenant_id FK
        string stripe_subscription_id
        enum status "active|past_due|cancelled"
        timestamp current_period_end
    }

    AUDIT_LOG {
        uuid id PK
        uuid tenant_id FK
        uuid actor_id FK
        string action "e.g. issue.created"
        jsonb metadata
        inet ip_address
        timestamp created_at
    }

    API_KEY {
        uuid id PK
        uuid user_id FK
        string key_prefix "first 8 chars"
        string key_hash
        timestamp expires_at
        string[] scopes
    }
4. State Diagram — PR 리뷰 라이프사이클
Pull Request가 생성부터 머지까지 거치는 복합 상태 전이. 중첩 상태(composite state)를 활용합니다.
stateDiagram-v2
    [*] --> Draft : Create PR

    Draft --> Open : Mark Ready for Review
    Draft --> Closed : Close

    state Open {
        [*] --> WaitingReview
        WaitingReview --> InReview : Reviewer assigned

        state InReview {
            [*] --> Reviewing
            Reviewing --> Approved : All reviewers approve
            Reviewing --> ChangesRequested : Request changes
            ChangesRequested --> Reviewing : Push new commits
        }

        InReview --> WaitingReview : Reviewer unassigned
    }

    state CI_Check <<choice>>
    Open --> CI_Check : CI Pipeline runs
    CI_Check --> MergeReady : CI passes + Approved
    CI_Check --> Open : CI fails (fix needed)

    state MergeConflict <<choice>>
    MergeReady --> MergeConflict : Check conflicts
    MergeConflict --> Merged : No conflicts → Squash & Merge
    MergeConflict --> Open : Has conflicts → Rebase needed

    Open --> Closed : Close PR
    Closed --> Open : Reopen

    Merged --> [*]

    note right of Draft
        Branch protection rules
        may require reviews,
        CI checks, and linear history
    end note

    note left of Merged
        Post-merge: auto-delete branch,
        trigger CD pipeline,
        update linked issues
    end note
5. Git Graph — Feature Branch 전략 (GitFlow 변형)
실제 프로젝트의 릴리스 사이클을 gitGraph로 표현.
gitGraph
    commit id: "init"
    commit id: "v1.0.0" tag: "v1.0.0"

    branch develop
    checkout develop
    commit id: "setup-ci"

    branch feature/auth
    checkout feature/auth
    commit id: "add-login-api"
    commit id: "add-jwt-middleware"
    commit id: "add-refresh-token"

    checkout develop
    merge feature/auth id: "merge-auth" tag: "auth-done"

    branch feature/dashboard
    checkout feature/dashboard
    commit id: "dashboard-layout"
    commit id: "add-charts"

    checkout develop
    commit id: "fix-lint-config"
    merge feature/dashboard id: "merge-dashboard"

    branch release/1.1
    checkout release/1.1
    commit id: "bump-version"
    commit id: "fix-edge-case"

    checkout main
    merge release/1.1 id: "release-1.1" tag: "v1.1.0"

    checkout develop
    merge release/1.1 id: "backport-fix"

    branch hotfix/security-patch
    checkout hotfix/security-patch
    commit id: "patch-xss-vuln"

    checkout main
    merge hotfix/security-patch id: "hotfix" tag: "v1.1.1"

    checkout develop
    merge hotfix/security-patch id: "backport-hotfix"
    commit id: "continue-dev"
6. Gantt Chart — 스프린트 플래닝 & 릴리스 일정
실제 2주 스프린트 기반 릴리스 계획.
gantt
    dateFormat YYYY-MM-DD
    section Test
    A :a1, after a2, 3d
    B :after a1, 2d
7. Class Diagram — 플러그인 아키텍처 (Strategy + Observer 패턴)
Eclipse RCP 스타일의 플러그인 시스템을 클래스 다이어그램으로 표현. 인터페이스, 추상 클래스, 제네릭, 패턴 적용을 보여줍니다.
classDiagram
    direction TB

    class IPlugin {
        <<interface>>
        +getId() String
        +getVersion() SemVer
        +activate(context: PluginContext) void
        +deactivate() void
    }

    class AbstractPlugin {
        <<abstract>>
        #context: PluginContext
        #logger: Logger
        +activate(context: PluginContext) void
        +deactivate() void
        #onActivate()* void
        #onDeactivate()* void
        #registerCommand(id: String, handler: CommandHandler) void
    }

    class PluginContext {
        -services: Map~String, Object~
        -subscriptions: Disposable[]
        +getService~T~(type: Class~T~) T
        +registerService~T~(type: Class~T~, impl: T) void
        +subscribe(event: String, listener: EventListener) Disposable
    }

    class PluginRegistry {
        -plugins: Map~String, IPlugin~
        -depGraph: DAG~String~
        +register(descriptor: PluginDescriptor) void
        +resolve() IPlugin[]
        +activate(id: String) void
        +deactivateAll() void
        -topologicalSort() String[]
    }

    class EventBus {
        -listeners: Map~String, Set~EventListener~~
        +emit(event: String, data: Object) void
        +on(event: String, listener: EventListener) Disposable
        +once(event: String, listener: EventListener) Disposable
        +off(event: String, listener: EventListener) void
    }

    class ICommandHandler {
        <<interface>>
        +execute(args: Object) Promise~Result~
        +canExecute(args: Object) boolean
    }

    class CommandRegistry {
        -commands: Map~String, ICommandHandler~
        +register(id: String, handler: ICommandHandler) void
        +execute(id: String, args: Object) Promise~Result~
        +getAll() CommandDescriptor[]
    }

    class EditorPlugin {
        -editors: Map~String, EditorInstance~
        +openFile(path: String) EditorInstance
        +getActiveEditor() EditorInstance
        #onActivate() void
    }

    class GitPlugin {
        -repo: Repository
        +getStatus() FileStatus[]
        +commit(msg: String) Commit
        +push(remote: String) void
        #onActivate() void
    }

    class TerminalPlugin {
        -sessions: TerminalSession[]
        +createSession(shell: String) TerminalSession
        +getActiveSession() TerminalSession
        #onActivate() void
    }

    IPlugin <|.. AbstractPlugin : implements
    AbstractPlugin <|-- EditorPlugin
    AbstractPlugin <|-- GitPlugin
    AbstractPlugin <|-- TerminalPlugin
    AbstractPlugin --> PluginContext : uses
    PluginRegistry o-- IPlugin : manages
    PluginContext --> EventBus : contains
    PluginContext --> CommandRegistry : contains
    ICommandHandler <|.. EditorPlugin : implements
    ICommandHandler <|.. GitPlugin : implements
    CommandRegistry o-- ICommandHandler : stores

    note for PluginRegistry "Dependency resolution via\ntopological sort on DAG.\nCyclic deps → error"
    note for EventBus "Observer pattern:\nloose coupling between plugins"
8. Kanban Board — 스프린트 태스크 보드
v11의 신규 다이어그램 타입. 실제 스프린트 보드를 표현합니다.
---
---
config:
  kanban:
    ticketBaseUrl: 'https://mermaidchart.atlassian.net/browse/#TICKET#'
---
kanban
  Todo
    [Create Documentation]
    docs[Create Blog about the new diagram]
  [In progress]
    id6[Create renderer so that it works in all cases. We also add some extra text here for testing purposes. And some more just for the extra flare.]
  id9[Ready for deploy]
    id8[Design grammar]@{ assigned: 'knsv' }
  id10[Ready for test]
    id4[Create parsing tests]@{ ticket: MC-2038, assigned: 'K.Sveidqvist', priority: 'High' }
    id66[last item]@{ priority: 'Very Low', assigned: 'knsv' }
  id11[Done]
    id5[define getData]
    id2[Title of diagram is more than 100 chars when user duplicates diagram with 100 char]@{ ticket: MC-2036, priority: 'Very High'}
    id3[Update DB function]@{ ticket: MC-2037, assigned: knsv, priority: 'High' }

  id12[Can't reproduce]
    id3[Weird flickering in Firefox]
9. Sequence Diagram — OAuth2 Authorization Code Flow (PKCE)
보안 관련 프로토콜을 상세히 문서화한 예시.
sequenceDiagram
    participant App as SPA (Client)
    participant Browser as Browser
    participant AuthZ as Authorization Server
    participant Token as Token Endpoint
    participant API as Resource Server

    Note over App: Generate code_verifier (random 43-128 chars)<br/>code_challenge = BASE64URL(SHA256(code_verifier))

    App ->> Browser: Redirect to /authorize
    Browser ->> AuthZ: GET /authorize?<br/>response_type=code<br/>&client_id=spa-app<br/>&redirect_uri=https://app.example.com/callback<br/>&scope=openid profile api:read<br/>&state=xyz123<br/>&code_challenge=E9Melhoa2OwvFrEMTJguCHaoeK1t8...<br/>&code_challenge_method=S256

    AuthZ ->> Browser: Show Login Page
    Browser ->> AuthZ: Submit credentials
    AuthZ ->> AuthZ: Authenticate user
    AuthZ ->> Browser: 302 Redirect to callback?code=SplxlOBeZQQ&state=xyz123
    Browser ->> App: Callback with auth code

    App ->> App: Verify state matches
    App ->>+ Token: POST /token<br/>grant_type=authorization_code<br/>&code=SplxlOBeZQQ<br/>&redirect_uri=https://app.example.com/callback<br/>&client_id=spa-app<br/>&code_verifier=dBjftJeZ4CVP-mB92K27uhbUJU1p1r_wW1gFWFOEjXk

    Note over Token: Verify: BASE64URL(SHA256(code_verifier)) == stored code_challenge

    Token -->>- App: 200 OK<br/>{ access_token, refresh_token, id_token, expires_in: 3600 }

    Note over App: Store tokens in memory (NOT localStorage)

    App ->>+ API: GET /api/user/profile<br/>Authorization: Bearer eyJhbGciOi...
    API ->> API: Validate JWT signature & claims
    API -->>- App: 200 OK { user data }

    Note over App: Token expired after 1 hour

    App ->>+ Token: POST /token<br/>grant_type=refresh_token<br/>&refresh_token=tGzv3JOkF0XG5Qx2TlKWIA<br/>&client_id=spa-app
    Token ->> Token: Rotate refresh token
    Token -->>- App: New access_token + new refresh_token
10. Flowchart — 인시던트 대응 런북 (On-Call)
실제 SRE 팀의 인시던트 대응 절차를 런북으로 표현.
flowchart TD
    alert["🚨 Alert Triggered\n(PagerDuty / Grafana)"]
    ack["Acknowledge Alert\n(5분 이내)"]
    assess["심각도 평가"]

    alert --> ack --> assess

    assess --> sev{Severity?}

    sev -- "SEV1\n서비스 전면 장애" --> war_room
    sev -- "SEV2\n주요 기능 장애" --> investigate
    sev -- "SEV3\n경미한 이슈" --> log_ticket

    war_room["🔴 War Room 오픈\n• Slack #incident-sev1\n• Zoom bridge 시작\n• 경영진 알림"]
    war_room --> ic_assign["Incident Commander 지정"]
    ic_assign --> investigate

    investigate["원인 조사"]
    investigate --> check_metrics["메트릭 확인\n• Error rate\n• Latency p99\n• CPU/Memory"]
    check_metrics --> check_deploys{"최근 배포\n있었나?"}

    check_deploys -- "Yes" --> rollback_decide{롤백 가능?}
    rollback_decide -- "Yes" --> rollback["🔙 즉시 롤백\nkubectl rollout undo"]
    rollback_decide -- "No" --> deep_dive

    check_deploys -- "No" --> check_infra{"인프라 이슈?"}
    check_infra -- "DB" --> db_check["DB 상태 확인\n• Connection pool\n• Slow queries\n• Replication lag"]
    check_infra -- "Network" --> net_check["네트워크 확인\n• DNS resolution\n• TLS certificates\n• Load balancer health"]
    check_infra -- "3rd Party" --> vendor_check["외부 서비스 상태 확인\n• Status page\n• API health check"]
    check_infra -- "Unknown" --> deep_dive

    deep_dive["Deep Dive 분석\n• 로그 (Kibana/Loki)\n• Traces (Jaeger)\n• Thread dump"]

    rollback --> verify
    db_check --> mitigate["완화 조치 적용"]
    net_check --> mitigate
    vendor_check --> mitigate
    deep_dive --> mitigate

    mitigate --> verify["서비스 정상 확인\n• Health check green\n• Error rate < baseline\n• Customer reports 감소"]

    verify --> resolved{해결 확인?}
    resolved -- "Yes" --> post_incident
    resolved -- "No" --> investigate

    post_incident["📝 포스트모템\n• Timeline 정리\n• Root cause 분석\n• Action items 도출"]
    log_ticket["📋 Jira 티켓 생성\n→ 다음 스프린트 처리"]

    post_incident --> done["✅ 인시던트 종료"]
    log_ticket --> done

    style alert fill:#E74C3C,color:#fff
    style war_room fill:#E74C3C,color:#fff
    style rollback fill:#F39C12,color:#fff
    style done fill:#2ECC71,color:#fff
    style post_incident fill:#3498DB,color:#fff
11. C4 Context Diagram (Flowchart 활용) — 시스템 아키텍처 개요
C4 Model의 Context Level을 Mermaid로 표현.
flowchart TB
    subgraph boundary["Enterprise Boundary"]
        direction TB

        subgraph core["Core Platform"]
            api["🖥️ API Gateway\n(Kong / Nginx)"]
            app["📱 Web Application\n(Next.js)"]
            mobile["📱 Mobile App\n(React Native)"]
            worker["⚙️ Background Workers\n(Bull + Redis)"]
        end

        subgraph data["Data Layer"]
            pg[("🐘 PostgreSQL\nPrimary DB")]
            redis[("🔴 Redis\nCache + Queue")]
            es[("🔍 Elasticsearch\nSearch Engine")]
            s3[("📦 S3\nFile Storage")]
        end

        subgraph infra["Infrastructure"]
            k8s["☸️ Kubernetes\n(EKS)"]
            monitor["📊 Monitoring\n(Prometheus + Grafana)"]
            log["📋 Logging\n(Loki + Fluentd)"]
        end
    end

    users(["👥 End Users"])
    admin(["🔧 Admin Users"])
    ci["🔄 CI/CD\n(GitHub Actions)"]
    idp["🔐 Auth0\n(Identity Provider)"]
    stripe["💳 Stripe\n(Payments)"]
    sendgrid["✉️ SendGrid\n(Email)"]
    slack_ext["💬 Slack\n(Notifications)"]

    users --> app
    users --> mobile
    admin --> app
    app --> api
    mobile --> api
    api --> pg
    api --> redis
    api --> es
    worker --> pg
    worker --> redis
    worker --> s3
    api --> idp
    api --> stripe
    worker --> sendgrid
    worker --> slack_ext
    ci --> k8s
    k8s --> monitor
    k8s --> log

    style boundary fill:none,stroke:#999,stroke-dasharray: 5 5
    style core fill:#E8F4FD,stroke:#2980B9
    style data fill:#FEF9E7,stroke:#F39C12
    style infra fill:#FDEDEC,stroke:#E74C3C
12. Requirement Diagram — GDPR 컴플라이언스 요구사항
규제 준수 요구사항을 추적하는 Requirement Diagram.
    requirementDiagram

    requirement test_req {
    id: 1
    text: the test text.
    risk: high
    verifymethod: test
    }

    functionalRequirement test_req2 {
    id: 1.1
    text: the second test text.
    risk: low
    verifymethod: inspection
    }

    performanceRequirement test_req3 {
    id: 1.2
    text: the third test text.
    risk: medium
    verifymethod: demonstration
    }

    interfaceRequirement test_req4 {
    id: 1.2.1
    text: the fourth test text.
    risk: medium
    verifymethod: analysis
    }

    physicalRequirement test_req5 {
    id: 1.2.2
    text: the fifth test text.
    risk: medium
    verifymethod: analysis
    }

    designConstraint test_req6 {
    id: 1.2.3
    text: the sixth test text.
    risk: medium
    verifymethod: analysis
    }

    element test_entity {
    type: simulation
    }

    element test_entity2 {
    type: word doc
    docRef: reqs/test_entity
    }

    element test_entity3 {
    type: "test suite"
    docRef: github.com/all_the_tests
    }


    test_entity - satisfies -> test_req2
    test_req - traces -> test_req2
    test_req - contains -> test_req3
    test_req3 - contains -> test_req4
    test_req4 - derives -> test_req5
    test_req5 - refines -> test_req6
    test_entity3 - verifies -> test_req5
    test_req <- copies - test_entity2
13. User Journey — 개발자 온보딩 경험
신규 개발자가 팀에 합류해서 첫 PR을 머지하기까지의 여정.
journey
    title 신규 개발자 온보딩 Journey Map

    section Day 1 환경 셋업
        노트북 수령 및 계정 생성: 3: 신입, IT팀
        개발 환경 설치 (IDE / Docker / k8s): 2: 신입
        Git repo clone 및 빌드 성공: 4: 신입
        Slack 채널 가입 및 자기소개: 5: 신입, 팀원

    section Day 2-3 코드베이스 이해
        아키텍처 문서 읽기: 3: 신입
        멘토와 코드 워크스루: 5: 신입, 멘토
        로컬에서 서비스 실행: 2: 신입
        테스트 실행 및 디버깅: 3: 신입

    section Day 4-5 첫 기여
        Good First Issue 선택: 4: 신입, 멘토
        브랜치 생성 및 구현: 4: 신입
        테스트 작성: 3: 신입
        첫 PR 제출: 5: 신입

    section Week 2 정착
        코드 리뷰 피드백 반영: 3: 신입
        첫 PR 머지 성공: 5: 신입, 리뷰어
        스탠드업 미팅 참여: 4: 신입, 팀원
        두 번째 이슈 자율 선택: 5: 신입
14. Packet Diagram — TCP 3-Way Handshake 패킷 구조
v11의 신규 다이어그램. 네트워크 패킷 구조를 시각화합니다.
packet-beta
    title TCP SYN Packet Structure (3-Way Handshake - Step 1)
    0-15: "Source Port (e.g. 52431)"
    16-31: "Destination Port (e.g. 443)"
    32-63: "Sequence Number (ISN: 0xA1B2C3D4)"
    64-95: "Acknowledgment Number (0x00000000)"
    96-99: "Data Offset (5)"
    100-102: "Reserved"
    103: "NS"
    104: "CWR"
    105: "ECE"
    106: "URG"
    107: "ACK=0"
    108: "PSH"
    109: "RST"
    110: "SYN=1"
    111: "FIN"
    112-127: "Window Size (65535)"
    128-143: "Checksum"
    144-159: "Urgent Pointer"
15. Sankey Diagram — 유저 퍼널 분석
사용자 유입 경로부터 전환까지의 흐름량을 시각화.
sankey-beta

Google Ads,Landing Page,12000
Organic Search,Landing Page,8500
Social Media,Landing Page,4200
Email Campaign,Landing Page,3800
Referral,Landing Page,2500

Landing Page,Signup Page,18600
Landing Page,Bounce,12400

Signup Page,Signup Complete,9800
Signup Page,Drop Off,8800

Signup Complete,Onboarding Start,8900
Signup Complete,Inactive,900

Onboarding Start,Onboarding Complete,6200
Onboarding Start,Abandoned,2700

Onboarding Complete,Free Trial Active,5800
Onboarding Complete,Skipped Trial,400

Free Trial Active,Paid Conversion,2100
Free Trial Active,Trial Expired,3700

Paid Conversion,Monthly Plan,1500
Paid Conversion,Annual Plan,600
16. Timeline — 기술 스택 진화 히스토리
프로젝트의 기술적 마일스톤을 타임라인으로 정리.
timeline
    title Project Aurora — 기술 스택 진화
    2023 Q1 : 프로젝트 시작
             : Monolith (Express + EJS)
             : PostgreSQL + Redis
             : Heroku 배포
    2023 Q3 : Frontend 분리 (React SPA)
             : REST API 도입
             : GitHub Actions CI
    2024 Q1 : TypeScript 전환 완료
             : Next.js 마이그레이션
             : Vercel + AWS 하이브리드 배포
    2024 Q3 : 마이크로서비스 분리 시작
             : Kubernetes (EKS) 도입
             : gRPC 서비스간 통신
             : OpenTelemetry 계측
    2025 Q1 : Event-driven 아키텍처
             : Kafka 메시지 브로커
             : CQRS 패턴 적용
    2025 Q3 : AI 기능 통합
             : RAG 파이프라인 (Embedding + pgvector)
             : Edge Computing (Cloudflare Workers)
    2026 Q1 : Multi-region 배포
             : CockroachDB (Geo-distributed)
             : Feature Flag 시스템 (자체 구축)
17. Quadrant Chart — 기술 부채 우선순위 매트릭스
기술 부채 항목들을 Impact × Effort로 매핑.
quadrantChart
    title Reach and engagement of campaigns
    x-axis Low Reach --> High Reach
    y-axis Low Engagement --> High Engagement
    quadrant-1 We should expand
    quadrant-2 Need to promote
    quadrant-3 Re-evaluate
    quadrant-4 May be improved
    Campaign A: [0.3, 0.6]
    Campaign B: [0.45, 0.23]
    Campaign C: [0.57, 0.69]
    Campaign D: [0.78, 0.34]
    Campaign E: [0.40, 0.34]
    Campaign F: [0.35, 0.78]
18. 아키텍처 다이어그램
architecture-beta
    group targets(server)[Monitored Hosts]
    group collect(cloud)[Collection Layer]
    group store(database)[Storage]
    group visual(cloud)[Visualization]

    service app(server)[App Servers] in targets
    service node_exp(server)[Node Exporter] in targets
    service filebeat(server)[Filebeat] in targets
    service prom(server)[Prometheus] in collect
    service logstash(server)[Logstash] in collect
    service tsdb(database)[Prometheus TSDB] in store
    service elastic(database)[Elasticsearch] in store
    service grafana(internet)[Grafana] in visual
    service kibana(internet)[Kibana] in visual

    node_exp:R --> L:prom
    filebeat:R --> L:logstash
    prom:B --> T:tsdb
    logstash:B --> T:elastic
    tsdb:R --> L:grafana
    elastic:R --> L:kibana
부록: Mermaid v11 다이어그램 타입 정리
| 다이어그램 | 키워드 | 주요 용도 |
|---|---|---|
| Flowchart | flowchart |
프로세스, 아키텍처, 의사결정 |
| Sequence | sequenceDiagram |
API 흐름, 프로토콜, 통신 |
| Class | classDiagram |
OOP 설계, 패턴 문서화 |
| State | stateDiagram-v2 |
상태 기계, 라이프사이클 |
| ER | erDiagram |
데이터 모델링 |
| Gantt | gantt |
프로젝트 일정 |
| Git Graph | gitGraph |
브랜칭 전략 |
| User Journey | journey |
UX 플로우, 온보딩 |
| Pie | pie |
비율 시각화 |
| Quadrant | quadrantChart |
2×2 매트릭스 분석 |
| Requirement | requirementDiagram |
요구사항 추적 |
| Timeline | timeline |
마일스톤, 히스토리 |
| Sankey | sankey-beta |
흐름량 시각화 |
| Kanban | kanban |
태스크 보드 (v11 신규) |
| Packet | packet-beta |
네트워크 패킷 구조 (v11 신규) |
| Architecture | architecture-beta |
인프라 토폴로지 (v11 신규) |
| Block | block-beta |
블록 다이어그램 |
| Mindmap | mindmap |
마인드맵 |
| XY Chart | xychart-beta |
꺾은선/막대 그래프 |
| ZenUML | zenuml |
시퀀스 다이어그램 (대안 문법) |
결함보고서
Claude 4.7 아키텍처의 축자주의적 전환과 에이전트 운영 결함 분석
본 보고서는 Claude 4.6(Adaptive)에서 4.7(Literal) 모델로의 전환 과정에서 발생하는 기술적 오작동 사례를 분석한다. 특히 서버 관리 및 파일 시스템 접근 권한이 부여된 에이전트 환경에서 보고된 데이터 파괴, 권한 오인, 컨텍스트 유실 현상을 기술적 관점에서 상세히 기술한다.
0. 기술 용어 정의 (Technical Terminology)
- 축자주의 (Literalism): 모델이 지시사항의 맥락적 의도를 추론하기보다 텍스트에 명시된 단어와 제약 조건을 문자 그대로(Word-for-word) 이행하려는 성향.[1, 2]
- 상태 직렬화 오류 (State Serialization Error): 파일의 특정 섹션만 수정하는 정밀 편집(Surgical Edit) 대신 파일 전체를 다시 쓰는 도구(Write)를 사용하여 기존 데이터를 유실시키는 현상.[3]
- MRCR (Multi-Round Coreference Resolution): 대규모 컨텍스트 내에서 상호 참조되는 정보를 정확히 식별하고 검색하는 능력 지표.[4]
- 적응형 사고 (Adaptive Thinking): 작업의 복잡도에 따라 모델이 추론에 투입할 사고 토큰(Thinking Tokens)의 양을 동적으로 결정하는 메커니즘.
- 하네스 팽창 (Harness Bloat): 매 턴마다
claude.md, 스킬 목록, 메모리 인덱스 등이 시스템 프롬프트에 주입되어 토큰 소모량이 기하급수적으로 증가하는 현상.
1. 축자주의적 해석에 따른 파일 시스템 및 문서 파괴 메커니즘
Claude 4.7은 이전 버전인 4.6이 지시사항을 느슨하게 해석(Loose interpretation)하여 사용자 의도를 보정해주던 성향을 탈피하고, 입력된 텍스트를 엄격하게 수행하는 축자주의적 특성을 강화했다. 이러한 변화는 정밀한 제어가 필요한 환경에서는 유리하나, 기존의 모호한 프롬프트를 처리할 때는 파괴적인 결과를 초래한다.
1.1. "간결한 정리" 요청과 정보 증발 현상
사용자가 "이 문서를 요약하라. 간결하게 유지하라"는 지시를 내렸을 때, 4.6 모델은 약 150단어 내외로 핵심 내용을 보존하며 요약했으나, 4.7 모델은 'Short'를 물리적 제약 조건으로 인식하여 50단어 미만의 극단적인 요약을 산출하며 핵심 맥락을 삭제하는 사례가 빈번하다.[5, 6] 이는 4.7 모델이 사용자의 '맥락적 의도'를 파악하기보다 '단어의 사전적 의미'에 가중치를 두어 토큰을 생성하기 때문이다. 특히 "테스트 디렉토리를 정리하라"는 지시는 4.7 환경에서 "디렉토리 내 모든 파일의 소거"로 직역되어 정상적인 테스트 환경이 파괴되는 사고로 이어진다.
1.2. 정밀 편집 실패 및 전체 덮어쓰기 사고 (Issue #51058)
Claude Code 환경에서 README.md 파일에 특정 변수 설명을 추가하라는 요청을 받은 모델이 파일의 기존 내용을 유지하며 정밀 편집(Edit)을 수행하는 대신, Write 도구를 호출하여 파일 전체를 요청된 단 한 줄의 내용으로 덮어씌우는 사례가 보고되었다.[3] 이는 모델이 이전 버전의 정밀한 차분(Diff) 적용 로직보다 상태를 단순화하려는 경향을 보이면서 발생하는 '상태 직렬화 오류'의 전형적인 사례다. 윈도우 환경의 Pycharm 터미널 등 특정 I/O 스트림 환경에서 파일 잠금이 발생할 때 모델은 이를 "처음부터 다시 작성해야 하는 상태"로 오판하는 경향이 강화되었다.[3]
2. 서버 관리 운영 중 발생한 치명적 오작동 사례
Claude 4.7 에이전트가 파일 시스템 및 서버 관리 도구에 직접 접근할 때 발생하는 오작동은 단순한 텍스트 오류를 넘어 실질적인 인프라 손실로 이어진다.
2.1. 디렉토리 일괄 삭제 사고 (Issue #17353, #10077)
Claude Code 2.1.2 버전 사용 중 "데스크톱의 모든 파일이 삭제되었다"는 보고가 다수 접수되었다.[1, 7] 기술 분석 결과, 이 사고의 주요 트리거는 MaxFileReadTokenExceededError였다.[7] 모델이 대규모 토큰이 포함된 파일을 분석하려다 예외 처리에 실패하자, 작업을 중단하는 대신 파일 시스템 초기화(rm -rf)를 대안으로 선택한 정황이 확인된다.[1, 7] 이는 모델의 '작업 완수 지향성'이 안전 가드레일을 추월하여 발생한 에이전틱 사고로 분류된다.
2.2. UI 레이블 오인에 따른 서버 삭제 사고 (Issue #4737)
독일어 환경의 서버 관리 패널에서 '서버 삭제(Delete Server)'와 '스냅샷 삭제(Delete Snapshot)'가 동일한 레이블("Löschen")을 공유할 때, 모델이 시각적 위치나 맥락 정보를 무시하고 텍스트 레이블만으로 서버 삭제 버튼을 클릭한 사례가 보고되었다. 4.7 모델은 "스냅샷을 삭제한다"고 선언한 직후 서버 삭제 다이얼로그를 호출했다.[8] 이는 모델이 UI 엘리먼트의 논리적 계층 구조보다 텍스트의 표면적 일치 여부에 집중하는 축자주의적 한계를 드러낸 것이다.
3. 권한 시스템 및 설정 파일 관리의 설계 결함
Claude 4.7의 스킬 분할 및 권한 시스템은 보안을 강화하도록 설계되었으나, 실제 구현 단계에서는 보안 허위 양성과 동시성 제어 실패 문제를 야기한다.
3.1. 마크다운 Prose 텍스트의 명령어 오인 (Issue #31201)
Claude Code의 권한 전검 스캐너가 Markdown 문서 내의 일반 설명 문구를 실행 가능한 Bash 명령어로 오인하여 스킬 로딩을 차단하는 버그가 보고되었다.[9] 암호 설정 가이드 문서 중 "백틱(`) 문자를 포함한 암호를 주의하라"는 설명 문구가 포함된 경우, 스캐너는 문서 내의 백틱 기호 자체를 셸 주입 공격으로 간주하여 해당 스킬 파일의 사용 권한을 박탈한다.[9] 이는 보안 가드레일이 코드 블록 외부의 텍스트와 실행 가능한 인자를 분리하지 못하는 정규표현식 기반 매칭의 한계 때문이다.[9]
3.2. 고부하 환경에서의.claude.json 파일 오염 (Issue #18998, #29143)
30개 이상의 세션이 동시에 작동하는 고병렬 환경에서 Claude Code의 공통 설정 파일인 .claude.json이 파손되는 현상이 보고되었다. 원인은 파일 접근 시 원자적 쓰기(Atomic write)나 파일 잠금(File locking) 메커니즘의 부재다. 여러 에이전트가 동시에 설정 상태를 업데이트하면서 파일 내용이 잘리거나(Truncated) 유효하지 않은 JSON 형식이 생성되어, 전체 프로젝트의 MCP 도구가 마비되는 연쇄 실패가 발생한다.
4. 장기 문맥 검색(MRCR) 퇴행과 적응형 사고의 실패
4.1. MRCR 지표의 급락과 정보 망각 현상
Claude 4.7은 4.6 대비 장기 문맥 검색 정확도(MRCR)가 78.3%에서 32.2%로 하락했다는 벤치마크 데이터가 존재한다. Anthropic은 모델이 '단순 검색'보다 '복잡한 추론'에 최적화되었다고 주장하나, 실제 사용자들은 5만 토큰 이전에 정의된 함수를 망각하거나 17/29로 보고된 테스트 결과를 16/29로 우기는 가스라이팅 행태를 보고하고 있다. 이는 모델이 문맥의 '양'을 늘리는 과정에서 개별 정보에 대한 '주의력 밀도'가 희석되었음을 시사한다.
4.2. "세차장(Car wash)" 카나리로 확인된 적응형 사고의 맹점
Claude 4.7의 적응형 사고 할당기는 짧은 질문에 대해 추론 예산을 0으로 할당하는 경향이 있다.[10] "세차장이 50m 앞에 있는데 차를 가져갈까 걸어갈까?"라는 논리 함정 질문에 대해, 할당기는 질문이 단순하다고 판단하여 사고 기능을 활성화하지 않는다.[10] 결과적으로 모델은 "50m는 가까우니 걸어가라"는 패턴 매칭 답변을 내놓으며, '세차를 하려면 차가 필요하다'는 상식적인 추론에 실패한다.[10] 이는 적응형 사고가 코드나 수학적 기호가 없는 자연어 지시사항의 복잡도를 과소평가하고 있음을 보여주는 기술적 증거다.[10]
5. 결론 및 실무적 개선 방안
분석된 오작동 사례를 종합할 때, Claude 4.7 모델을 안정적으로 운영하기 위해서는 다음과 같은 기술적 대응이 요구된다.
첫째, 모든 프롬프트에서 "간결하게"와 같은 모호한 형용사를 배제하고 "150단어 내외, 3가지 핵심 요소 포함"과 같은 정량적 지표를 명시해야 한다. 둘째, Write 도구에 의한 덮어쓰기 사고를 방지하기 위해 Edit 도구 사용을 강제하고, 파괴적 명령 실행 전 ls -R을 통한 사전 검증 루프를 시스템 프롬프트에 삽입해야 한다. 셋째, claude.md 파일의 비대화를 방지하기 위해 지침을 도메인별 스킬(Skills)로 분할하여 필요 시에만 로드하도록 구성함으로써 하네스 팽창을 억제해야 한다. 마지막으로, 모델의 자율적 권한 우회를 원천 차단하기 위해 프롬프트 기반의 통제가 아닌 Docker 컨테이너나 격리된 VM 환경과 같은 OS 수준의 샌드박싱 도입이 필수적이다.[11, 12]
VS Code Remote-SSH 접속 시 원격 서버에서 전체 개발환경이 실행되는 문제
개요
VS Code Remote-SSH로 서버에 접속하면, 단순 파일 탐색과 터미널 사용 목적이더라도 서버에 VS Code Server가 설치·실행되며, 언어 서버(tsserver, PHP Tools, HTML/JSON Language Server 등), 파일 감시자(fileWatcher), 확장 호스트(extensionHost) 등 전체 개발환경 프로세스가 원격 서버의 RAM과 CPU를 점유한다.
이것은 버그가 아니라 Microsoft의 의도된 설계(by design)이다. 그러나 운영 서버에서는 심각한 리소스 경합과 OOM 위험을 초래한다.
본 이슈에서는 아키텍처의 근거 자료, 실제 피해 사례, 수행한 대응 조치, 그리고 대안을 정리한다.
1. 문제 상세
1.1 발견 경위
2026-04-22, 서버 MemAvailable이 813MB(20.8%)로 저하된 원인을 조사한 결과, VS Code Server 관련 프로세스 13개가 RAM 2,362MB(서버 전체의 60.3%)를 점유하고 있었다.
접속자는 1명이었고, 파일 편집과 터미널만 사용하는 상태였다.
PID       RSS     프로세스                      비고
──────────────────────────────────────────────────────────────────────
184586    617MB   extensionHost                 DevSense 확장 4개 로드
184958    605MB   tsserver (semantic)            --max-old-space-size=3072
185085    341MB   devsense.phptools             PHP 전체 인덱싱
185184    186MB   devsense.intelli-php          AI 자동완성 모델
184957    163MB   tsserver (partial)            --max-old-space-size=3072
184213    103MB   server-main.js                VS Code Server 핵심
185204     89MB   html language server          내장 확장
184974     77MB   typingsInstaller              TS 타입 설치
184228     60MB   fileWatcher                   파일 변경 감시
184258     60MB   ptyHost                       통합 터미널
184994     49MB   json language server          내장 확장
184180     11MB   code command-shell            SSH 터널 진입점
184209      0MB   sh wrapper                    프로세스 래퍼
──────────────────────────────────────────────────────────────────────
합계     2362MB   13 프로세스
1.2 접속 해제 후에도 프로세스가 잔류
VS Code를 종료(접속 해제)해도 13개 프로세스 전량이 서버에 잔류했다. autoShutdown 기본 설정이 미작동하여 24시간 이상 점유가 지속되었다.
2. 원인: Microsoft의 Remote-SSH 아키텍처
2.1 공식 문서 근거
VS Code Remote-SSH 공식 문서
URL: https://code.visualstudio.com/docs/remote/ssh
핵심 설명: Remote-SSH 확장은 원격 머신에 VS Code Server를 설치하고, 명령어와 확장을 원격 머신에서 직접 실행한다. 소스 코드가 로컬에 없어도 IntelliSense, 코드 네비게이션, 디버깅 등 로컬 수준의 개발 경험을 제공하는 것이 목적이다.
원문: "the extension runs commands and other extensions directly on the remote machine. The extension will install VS Code Server on the remote OS"
이것은 SSH를 단순 파일 전송/터미널 용도로 사용하는 일반적인 기대와 근본적으로 다르다.
VS Code Remote Development Overview
URL: https://code.visualstudio.com/docs/remote/remote-overview
핵심 설명: Remote Development 확장 팩의 각 확장은 컨테이너, WSL, 또는 원격 머신에서 직접 명령어와 확장을 실행한다. 이를 통해 로컬에서 실행하는 것과 동일한 경험을 제공한다.
원문: "Each extension in the Remote Development extension pack can run commands and other extensions directly inside a container, in WSL, or on a remote machine so that everything feels as it does when you run locally."
Extension Host 아키텍처 문서
URL: https://code.visualstudio.com/api/advanced-topics/extension-host
VS Code는 확장을 두 가지로 분류한다:
- UI Extension (
extensionKind: ["ui"]): 테마, 스니펫, 키맵 등. 로컬에서 실행.- Workspace Extension (
extensionKind: ["workspace"]): 디버거, 린터, 언어 서버 등. 원격 서버에서 실행.대부분의 개발 확장은 Workspace Extension으로 분류되어 원격 서버에서 실행되는 것이 기본 동작이다.
원문: "
extensionKind: ["workspace"]— Indicates the extension requires access to workspace contents and therefore needs to run where the workspace is located."
Supporting Remote Development (확장 개발자용 가이드)
URL: https://code.visualstudio.com/api/advanced-topics/remote-extensions
확장이 양쪽 모두에서 실행 가능한 경우, UI Extension은 로컬 Extension Host에서, Workspace Extension은 Remote Extension Host(VS Code Server 안의 작은 서버)에서 실행된다.
remote.extensionKind설정으로 특정 확장의 실행 위치를 강제 변경할 수 있으나, 이는 테스트 용도로만 권장되며 확장이 정상 동작하지 않을 수 있다.원문: "Using remote.extensionKind allows you to quickly test published versions of extensions without having to modify their package.json and rebuild them."
Remote Development FAQ
URL: https://code.visualstudio.com/docs/remote/faq
VS Code Server는 Remote Development 확장의 구성요소이며, VS Code 클라이언트가 관리한다. 사용자가 접속할 때 자동으로 설치/업데이트되며, 별도 사용이나 다른 클라이언트의 사용은 의도되지 않았다.
최소 요구사항: 1GB RAM (권장 2GB RAM, 2코어 CPU).
원문: "1 GB RAM is required for remote hosts, but at least 2 GB RAM and a 2-core CPU is recommended."
2.3 tsserver 기본 힙 크기 문제
VS Code에 내장된 TypeScript 언어 서버(tsserver)의 기본 --max-old-space-size는 3072MB이다. 이것은 대규모 TypeScript 프로젝트(수십만 줄)를 위한 설정이다.
본 서버의 BookStack 프로젝트는 TS 파일 215개, 63,551줄이며, 실사용 메모리는 50~200MB 수준이다. 그러나 기본 설정이 적용되면 V8 힙 상한이 서버 RAM(3,919MB)의 78%가 된다.
tsserver는 semantic 인스턴스와 partial 인스턴스 2개가 동시 실행되므로, 이론상 힙 상한의 합계는 6,144MB로 서버 RAM의 157%에 달한다.
3. 관련 GitHub 이슈 (동일 문제 보고)
아래 이슈들은 동일한 아키텍처적 문제로 인한 피해를 보고한 것이다.
3.1 메모리 관련
| 이슈 | 제목/내용 | 핵심 |
|---|---|---|
| microsoft/vscode#151205 | Remote SSH RAM 과다 점유 | 모든 원격 확장을 비활성화해도 10GB 서버에서 RAM 3.7GB 점유. 다른 앱이 메모리 할당 실패로 종료. |
| microsoft/vscode-remote-release#9778 | vscode-server 메모리 누수 | 폴더를 열 때마다 별도 vscode-server 인스턴스 생성. 창을 닫아도 메모리 미회수. IDE 미사용 상태에서 8GB 잔류. |
| microsoft/vscode-remote-release#7825 | Remote SSH 메모리 고갈 | 모든 확장 제거 후에도 fileWatcher 프로세스가 메모리를 제한 없이 소비. |
| microsoft/vscode-remote-release#3195 | VSCode Server Node 리소스 과다 소비 | WSL 2에서 폴더 열기만으로 Node 프로세스가 RAM과 CPU를 전부 소비. 메모리 누수로 BSOD 유발. |
| microsoft/vscode-remote-release#10567 | 비정상 메모리/CPU 사용으로 인한 크래시 | Ubuntu 24 서버에서 접속 시 확장 자동 설치와 함께 리소스 소비 급증. |
3.2 CPU 관련
| 이슈 | 제목/내용 | 핵심 |
|---|---|---|
| microsoft/vscode-remote-release#3319 | tsserver 고 CPU 사용 | AWS t2.micro에서 tsserver와 typingsInstaller가 CPU 80% 이상 점유. JS만 작업하는데 TS 언어 서버가 실행. cgroup CPU 제한 기능 요청. |
| microsoft/vscode-remote-release#2716 | 고 CPU 사용 | extensionHost 프로세스가 CPU 99% 점유. |
| microsoft/vscode-remote-release#1656 | 고 CPU 사용 | 다수 NodeJS 인스턴스로 인한 CPU 과부하. |
3.3 아키텍처 개선 요청
| 이슈 | 제목/내용 | 핵심 |
|---|---|---|
| microsoft/vscode#194583 | 확장 실행 위치 변경 UI 제공 요청 | remote.extensionKind 설정의 문서가 부실하고, 원격 서버에서 불필요한 리소스 사용 문제. "모든 확장을 ui로 실행" 옵션 요청. |
| microsoft/vscode-remote-release#9454 | 사전 설치된 서버/확장 환경 지원 요청 | 접속할 때마다 새 버전 설치. 기존 설치를 재사용하는 옵션 요청. |
4. 수행한 대응 조치
4.1 tsserver 힙 크기 제한
서버의 Machine settings(/root/.vscode-server/data/Machine/settings.json)에서 tsserver 힙 상한을 3,072MB → 256MB로 변경.
{
  "typescript.tsserver.maxTsServerMemory": 256
}
BookStack TS 215파일/63K줄 규모에 256MB는 충분하다.
4.2 서버 실행 불필요 확장 제거
서버에 자동 설치된 DevSense 확장 4개(phptools, intelli-php, composer, profiler)를 삭제. 합계 527MB + 디스크 145MB 회수.
rm -rf /root/.vscode-server/extensions/devsense.phptools-vscode-*
rm -rf /root/.vscode-server/extensions/devsense.intelli-php-vscode-*
rm -rf /root/.vscode-server/extensions/devsense.composer-php-vscode-*
rm -rf /root/.vscode-server/extensions/devsense.profiler-php-vscode-*
로컬 VS Code에서 재설치를 방지하기 위해 remote.extensionKind로 로컬 전용 실행 강제:
"remote.extensionKind": {
    "devsense.phptools-vscode": ["ui"],
    "devsense.intelli-php-vscode": ["ui"]
}
4.3 VS Code Server 설정 강화
{
  "remote.autoForwardPorts": false,
  "remote.autoShutdown": true,
  "remote.autoShutdownDelay": 10,
  "extensions.autoUpdate": false,
  "search.followSymlinks": false,
  "files.watcherExclude": {
    "**/vendor/**": true,
    "**/node_modules/**": true,
    "**/storage/**": true,
    "**/public/dist/**": true
  }
}
| 설정 | 변경 전 | 변경 후 | 효과 |
|---|---|---|---|
tsserver.maxTsServerMemory |
3072 | 256 | 인스턴스당 V8 힙 -92% |
autoShutdownDelay |
30분 | 10분 | 접속 해제 후 잔류 시간 -67% |
extensions.autoUpdate |
true | false | 백그라운드 확장 업데이트 방지 |
autoForwardPorts |
true | false | 불필요 포트 포워딩 차단 |
watcherExclude |
미설정 | 4경로 | fileWatcher 부하 축소 |
4.4 구버전 서버 디렉토리 정리
VS Code Server 업데이트마다 새 디렉토리가 누적됨. 5개 버전(1.9GB) → 2개 버전(869MB)으로 정리. 디스크 855MB 회수.
4.5 재발 방지 — 3중 방어 체계
단일 방어 수단은 실패할 수 있으므로 계층적 방어를 구축했다.
계층 1: autoShutdown (10분) 접속 해제 후 10분 대기 → VS Code Server 자동 종료.
계층 2: cron (매시간, 5h 임계)
/etc/cron.d/bookstack-vscode-cleanup:
autoShutdown 실패 시 백업. 5시간 이상 실행된 vscode-server 프로세스를 SIGTERM.
15 * * * * root ps -eo pid,etimes,cmd --no-headers | \
  awk '/vscode-server/ && $2 > 18000 {system("kill -TERM " $1)}' 2>/dev/null
계층 3: daily-cleanup.sh (05:45, 3개 서브섹션)
/var/www/bookstack/batch/daily-cleanup.sh 섹션 6에 추가:
- 6a. orphan 프로세스 정리 (5시간 임계)
- 6b. 금지 확장(DevSense) 자동 삭제 — 로컬에서 재설치되더라도 일 1회 자동 제거
- 6c. Machine settings 무결성 검증 — 설정이 변경되었을 경우 원래 값으로 복원
방어 계층 흐름:
접속 해제 → autoShutdown(10분) → cron(매시간, 5h) → daily-cleanup(매일, 5h) → 월간 재부팅

| 실패 시나리오                          | 최대 잔류 시간 |
|---------------------------------------|--------------|
| autoShutdown 정상 작동                 | 10분          |
| autoShutdown 실패 → cron 보정          | 6시간         |
| autoShutdown + cron 모두 실패 → daily  | 24시간        |
4.6 결과
                          Before              After               절감
────────────────────────────────────────────────────────────────────────
VS Code Server
  extensionHost           617MB               101MB               -84%
  tsserver (×2)           768MB                 0MB       (256MB 상한)
  PHPTools                341MB                 0MB               제거
  IntelliPHP              186MB                 0MB               제거
  기타 node (7→4개)       347MB               330MB
  ──────────────────────────────────────────────────────────
  소계                   2362MB               431MB               -82%

서버 전체
  used                   2773MB               991MB               -64%
  available               813MB              2603MB             +3.2배
  earlyoom 마진            225MB              2015MB             +9.0배
────────────────────────────────────────────────────────────────────────
접속 해제 후 10분 이내에 VS Code Server 전체가 종료되어 2,362MB 회수(RAM의 60%) 확인.
5. 대안 검토
5.1 SSH FS 확장
URL: https://marketplace.visualstudio.com/items?itemName=Kelvin.vscode-sshfs GitHub: https://github.com/SchoofsKelvin/vscode-sshfs
서버에 아무것도 설치하지 않고 순수 SSH/SFTP 프로토콜로 동작하는 경량 확장이다.
- 서버 프로세스: 0개
- 서버 RAM 사용: 0MB
- 파일 탐색기: O (VS Code 내 Explorer 통합)
- 터미널: O (원격 터미널 지원)
- IntelliSense/디버깅: X (미지원)
Microsoft Q&A에서도 Remote-SSH의 서버 부담 문제에 대한 대안으로 SSH FS가 권장되고 있다:
URL: https://learn.microsoft.com/en-us/answers/questions/5565268/visual-studio-code-extension-of-ssh-connection-oth
UNSW CSE 학과에서는 학생 서버 보호를 위해 Remote-SSH 대신 SSH FS 사용을 공식 권장한다:
URL: https://cgi.cse.unsw.edu.au/~learn/homecomputing/sshfs-remote/ 인용: "Remote-SSH 플러그인은 계정을 가득 채우고 서버를 느리게 만들 수 있으므로, 대신 SSH FS를 사용하라."
5.2 비교
| 방식 | 서버 프로세스 | 서버 RAM | IntelliSense | 파일탐색 | 터미널 | 서버 설치물 |
|---|---|---|---|---|---|---|
| Remote-SSH (기본) | 6~13개 | 431MB~2.3GB | O | O | O | VS Code Server (~1GB 디스크) |
| Remote-SSH (경량화 완료) | 4~6개 | 257~431MB | △ | O | O | VS Code Server (~869MB 디스크) |
| SSH FS | 0개 | 0MB | X | O | O | 없음 |
| 순수 SSH 터미널 | 0개 | 0MB | X | X | O | 없음 |
6. 결론 및 권장사항
6.1 운영서버에 Remote-SSH를 사용하는 것은 위험하다
Remote-SSH는 설계 자체가 "원격 서버를 로컬 개발 환경과 동일하게 사용"하는 것을 전제한다. 이 아키텍처는 개발 전용 VM이나 컨테이너에서는 합리적이지만, 운영 서버에서는 다음의 위험을 초래한다:
- 리소스 경합: 운영 서비스(Apache, MySQL, PDF 엔진 등)와 VS Code Server가 동일한 RAM/CPU를 공유
- 프로세스 잔류: autoShutdown 실패 시 접속 해제 후에도 수백 MB~수 GB의 프로세스가 무기한 잔류
- 확장 자동 설치: 로컬 PC에서 설치한 확장이 서버에 자동으로 설치·실행됨. 개발자가 의도하지 않아도 발생
- OOM kill 경합: earlyoom이나 커널 OOM killer가 운영 서비스 대신 VS Code를 kill하거나, 그 역으로 VS Code 때문에 운영 서비스가 kill될 수 있음
6.2 적용된 대응 (현재 상태)
현재 서버에는 Section 4의 모든 조치가 적용되어 있다:
- tsserver 힙 256MB 제한
- 불필요 확장 제거 + 재설치 방지
- 3중 방어 체계 (autoShutdown + cron + daily-cleanup)
- Machine settings 무결성 자동 복원
이로 인해 VS Code Server RSS가 2,362MB → 431MB(-82%)로 감소했으며, earlyoom 마진이 225MB → 2,015MB(+9.0배)로 확보되었다.
6.3 향후 검토
- SSH FS 전환 검토: 파일 탐색 + 터미널만 필요한 경우 SSH FS로 전환하면 서버 부담이 완전히 제거됨
- 운영서버 접속 가이드 문서화: Remote-SSH 접속 시 주의사항, 금지 확장 목록, 설정 기준값을 팀 위키에 게시
- VS Code Server 완전 제거 명령: 비상 시
Remote-SSH: Uninstall VS Code Server from Host...명령 또는 수동 정리 절차 문서화
7. 참고 자료 모음
Microsoft 공식 문서
| 문서 | URL |
|---|---|
| Remote-SSH 공식 가이드 | https://code.visualstudio.com/docs/remote/ssh |
| Remote Development Overview | https://code.visualstudio.com/docs/remote/remote-overview |
| Extension Host 아키텍처 | https://code.visualstudio.com/api/advanced-topics/extension-host |
| Supporting Remote Development (확장 개발자용) | https://code.visualstudio.com/api/advanced-topics/remote-extensions |
| Remote Development FAQ | https://code.visualstudio.com/docs/remote/faq |
| Remote Development Tips & Tricks | https://code.visualstudio.com/docs/remote/troubleshooting |
| VS Code Server 설명 | https://code.visualstudio.com/docs/remote/vscode-server |
GitHub 이슈
| 이슈 번호 | 제목 | URL |
|---|---|---|
| vscode#151205 | Remote SSH RAM 과다 점유 | https://github.com/microsoft/vscode/issues/151205 |
| vscode#194583 | 확장 실행 위치 변경 UI 요청 | https://github.com/microsoft/vscode/issues/194583 |
| vscode-remote-release#9778 | vscode-server 메모리 누수 | https://github.com/microsoft/vscode-remote-release/issues/9778 |
| vscode-remote-release#7825 | fileWatcher 메모리 고갈 | https://github.com/microsoft/vscode-remote-release/issues/7825 |
| vscode-remote-release#3319 | tsserver 고 CPU (t2.micro) | https://github.com/microsoft/vscode-remote-release/issues/3319 |
| vscode-remote-release#3195 | Node 리소스 과다 소비 (BSOD) | https://github.com/microsoft/vscode-remote-release/issues/3195 |
| vscode-remote-release#10567 | 비정상 메모리/CPU 크래시 | https://github.com/microsoft/vscode-remote-release/issues/10567 |
| vscode-remote-release#2716 | extensionHost CPU 99% | https://github.com/microsoft/vscode-remote-release/issues/2716 |
| vscode-remote-release#1656 | 다중 인스턴스 CPU 과부하 | https://github.com/microsoft/vscode-remote-release/issues/1656 |
| vscode-remote-release#9454 | 사전 설치 서버/확장 요청 | https://github.com/microsoft/vscode-remote-release/issues/9454 |
대안 도구
| 도구 | URL |
|---|---|
| SSH FS (VS Code 확장) | https://marketplace.visualstudio.com/items?itemName=Kelvin.vscode-sshfs |
| SSH FS GitHub | https://github.com/SchoofsKelvin/vscode-sshfs |
| Microsoft Q&A: Remote-SSH 대안 | https://learn.microsoft.com/en-us/answers/questions/5565268/ |
| UNSW CSE SSH FS 권장 가이드 | https://cgi.cse.unsw.edu.au/~learn/homecomputing/sshfs-remote/ |
Kubernetes 환경 JVM OOM Kill 원인 분석 — UseContainerSupport와 cgroup 메모리 인식 문제
로컬 서버에서 수년간 문제없이 돌아가던 Java 빌드가 K8s 컨테이너로 옮기자마자 OOM Kill로 죽기 시작했다. 메모리를 8GB나 줬는데도 죽고, 같은 빌드를 돌려도 메모리 사용량이 매번 다르다. 실제 운영 환경에서 발생한 이 문제를 추적한 기록이다.
문제 상황
기존에는 RHEL 7.6, 물리 메모리 64GB 서버에서 Ant + JDK 8u181로 빌드했다. 이걸 K8s 클러스터의 컨테이너 POD(memory limit 8GB)로 옮겼더니 빌드 도중 프로세스가 죽었다. 빌드 대상은 프래그먼트 30개짜리 호스트 프로젝트 1개, 소스 파일 7,000~8,000개 규모.
POD memory limit을 8GB로 잡아도 빌드 중 OOM Kill이 발생했고, 같은 프로젝트를 같은 설정으로 빌드해도 메모리 점유율이 매번 달랐다. 그리고 JVM의 OutOfMemoryError 로그가 어디에도 없었다. 로그가 안 남았다는 건, JVM이 에러를 던지기 전에 외부에서 프로세스 자체를 죽였다는 뜻이다.
원인: JVM이 컨테이너 메모리 제한을 모른다
JVM은 -Xmx를 따로 지정하지 않으면 "이 시스템의 물리 메모리"를 기준으로 기본 힙 크기를 잡는다. 보통 물리 메모리의 1/4. 로컬 서버에서는 물리 메모리 64GB니까 기본 힙 ~16GB, 전체 메모리에 여유가 충분하니 아무 문제가 없다.
K8s에서는 사정이 다르다. 각 POD에 cgroup으로 메모리 상한을 부여하는데, JDK 8u181은 이 cgroup 제한을 인식하지 못한다. JVM은 호스트 노드 전체 메모리를 보고 힙을 계산한다.
로컬 서버 (64GB):
  JVM이 보는 메모리 = 64GB (실제)
  기본 Xmx = ~16GB
  실제 사용 가능 = 64GB → 문제 없음

K8s POD (8GB limit, JDK 8u181):
  JVM이 보는 메모리 = 64GB (호스트 노드 전체)
  기본 Xmx = ~16GB (POD limit의 2배)
  실제 사용 가능 = 8GB → cgroup OOM Kill
JVM이 힙을 8GB 이상 확장하려는 순간 cgroup이 메모리 초과를 감지하고 SIGKILL을 보낸다. SIGKILL은 프로세스에 정리할 기회를 주지 않는다. OutOfMemoryError 출력도, shutdown hook 실행도, heap dump도 없다. 프로세스가 그냥 사라진다. 이게 로그가 안 남는 이유였다.
메모리 사용량이 매번 다른 현상도 여기서 나온다. JVM이 64GB 기준으로 힙을 잡으니 GC 타이밍에 따라 힙 확장 시점이 달라지고, 빌드 태스크의 스레드 스케줄링도 비결정적이라 대형 파일이 동시에 처리되는 타이밍이 빌드마다 다르다. POD가 다른 워커 노드에 배치되면 호스트 물리 메모리 자체가 달라져서 JVM의 기본 힙 계산도 바뀐다.
JDK 버전별 컨테이너 인식
JDK에는 이후 버전에서 컨테이너 인식 기능이 추가되었다.
- 8u131 ~ 8u181: -XX:+UseCGroupMemoryLimitForHeap 플래그가 있지만 실험적이고 기본 비활성. CPU는 인식 못 한다.
- 8u191+: -XX:+UseContainerSupport가 도입되어 cgroup v1에서 메모리와 CPU를 인식한다.
- 8u372+: cgroup v2도 지원. (Kubernetes 공식 문서 기준)
- JDK 11+: 컨테이너 인식이 완전히 내장.
한 가지 빠뜨리기 쉬운 점이 있는데, 8u191의 UseContainerSupport는 cgroup v1에서만 동작한다. RHEL 8은 cgroup v1이 기본이라 운영 환경에서는 보통 문제가 안 되지만, Docker Desktop(macOS/Windows)이나 최신 Linux 배포판은 cgroup v2를 쓰므로 로컬에서 테스트할 때 결과가 다를 수 있다.
해결
-Xmx 명시 (모든 환경에서 동작)
JDK 버전이나 cgroup 버전에 관계없이 -Xmx를 명시하면 JVM의 자동 계산을 덮어쓴다.
# POD memory limit = 8GB 기준
java \
  -Xmx4g \
  -Xms2g \
  -XX:MaxMetaspaceSize=512m \
  -jar your-build-tool.jar
-Xmx는 POD limit의 50~60%가 적당하다. JVM은 힙 외에 Metaspace, 스레드 스택, Native 메모리, GC 오버헤드를 별도로 쓰기 때문이다.
| 영역 | 할당 | 비고 |
|---|---|---|
| JVM Heap (-Xmx) | 4,096 MB (50%) | 애플리케이션 작업 영역 |
| Metaspace | 512 MB (6%) | 클래스 로딩 |
| Thread stacks | ~64 MB (1%) | 스레드 수에 비례 |
| Native / OS | ~3,500 MB (43%) | 커널 버퍼, cgroup 오버헤드 |
| 합계 | ≤ 8,192 MB | POD limit 이내 |
-Xmx를 POD limit과 똑같이 잡는 경우가 있는데(예: -Xmx8g), 이러면 힙 외 메모리가 limit을 넘어서 결국 OOM Kill이 다시 발생한다.
Ant 빌드라면 ANT_OPTS로 전달한다.
export ANT_OPTS="-Xmx4g -Xms2g -XX:MaxMetaspaceSize=512m"
ant build
CI 파이프라인에서도 마찬가지다.
# .gitlab-ci.yml
build:
  script:
    - export ANT_OPTS="-Xmx4g -Xms2g -XX:MaxMetaspaceSize=512m"
    - ant build
JDK 업그레이드 (권장)
8u191 이상으로 올리면 UseContainerSupport가 활성화되어 JVM이 컨테이너 메모리를 자동 인식한다. 비율 기반 설정이 가능해진다.
java \
  -XX:MaxRAMPercentage=50.0 \
  -XX:MaxMetaspaceSize=512m \
  -jar your-build-tool.jar
MaxRAMPercentage=50.0은 컨테이너 메모리의 50%를 힙 상한으로 쓰겠다는 뜻이다. POD memory limit을 나중에 바꿔도 빌드 스크립트를 건드릴 필요가 없다.
8u181에서 8u191 전용 옵션을 쓰면 JVM이 기동 안 된다
8u181 환경에서 -XX:+UseContainerSupport나 -XX:MaxRAMPercentage를 넣으면 Unrecognized VM option 에러가 나고 JVM이 시작조차 하지 않는다. 여러 환경에 JDK 버전이 섞여 있으면 -Xmx가 안전하다.
멀티스레드와 메모리 증폭
빌드 도구가 멀티스레드로 동작하면 스레드 수도 메모리에 영향을 준다. 예를 들어 JS minify를 Google Closure Compiler로 처리하는 빌드에서는 파일마다 AST를 메모리에 올린다. 12개 스레드가 동시에 대형 파일을 처리하면 피크 메모리가 확 올라간다.
8u181에서는 Runtime.getRuntime().availableProcessors()가 호스트 노드 전체 코어 수를 반환해서, 빌드 도구가 이 값으로 스레드 수를 정하면 의도보다 많은 스레드가 뜬다. 빌드 도구에 스레드 수 제한 옵션이 있으면 POD 환경에서는 낮춰 두는 게 좋다.
테스트
Docker 컨테이너에서 실제로 재현되는지 확인했다.
환경
테스트 환경인 Docker Desktop은 cgroup v2로 동작한다. 8u191의 UseContainerSupport는 cgroup v1만 지원하므로 JVM 자동 인식 검증에는 cgroup v2를 지원하는 8u372를 썼다. 실 운영 환경(RHEL 8)은 cgroup v1이 기본이라 8u191에서도 같은 동작을 할 것으로 본다.
- Docker Desktop 27.3.1 (macOS, aarch64), cgroup v2
- openjdk:8u181-jdk-slim, eclipse-temurin:8u372-b07-jdk
시뮬레이터
멀티스레드 빌드의 메모리 패턴을 재현하는 MemorySimulator를 만들었다. 빌드 엔진의 스레드 수 결정 로직을 그대로 가져오고, 각 스레드에서 소스 문자열 + AST + 결과 문자열을 동시에 잡아 minify의 메모리 패턴을 흉내냈다.
// 빌드 엔진과 동일한 스레드 수 결정 로직
int cpuCount = (Math.max(1, Runtime.runtime.availableProcessors() - 1) * 2);
int threadCount = Math.min(taskCount, cpuCount);
threadCount = Math.min(GLOBAL_MAX_THREAD_COUNT, threadCount);  // 상한 12
인자로 스레드 수, 태스크 수, 태스크당 할당량(MB)을 받는다.
FROM openjdk:8u181-jdk-slim
WORKDIR /build
COPY src/MemorySimulator.java .
RUN javac MemorySimulator.java
ENTRYPOINT ["java", "-cp", "/build"]
실행
docker build -f Dockerfile.8u181 -t oom-test:8u181 .
docker build -f Dockerfile.8u372 -t oom-test:8u372 .

# TEST 1: 8u181 + Xmx 미설정 + 256MB → OOM 재현
docker run --rm --memory=256m --memory-swap=256m \
  oom-test:8u181 MemorySimulator 12 100 15

# TEST 2: 8u181 + -Xmx128m → OOM 방지
docker run --rm --memory=256m --memory-swap=256m \
  oom-test:8u181 -Xmx128m -Xms64m -XX:MaxMetaspaceSize=32m \
  MemorySimulator 2 30 3

# TEST 3a/3b: 스레드 2개 vs 12개
docker run --rm --memory=512m --memory-swap=512m \
  oom-test:8u181 -Xmx256m -Xms128m -XX:MaxMetaspaceSize=64m \
  MemorySimulator 2 50 5    # 3a

docker run --rm --memory=512m --memory-swap=512m \
  oom-test:8u181 -Xmx256m -Xms128m -XX:MaxMetaspaceSize=64m \
  MemorySimulator 12 50 5   # 3b

# TEST 4: 8u372 + Xmx 미설정 → 자동 인식
docker run --rm --memory=512m --memory-swap=512m \
  oom-test:8u372 MemorySimulator 2 50 5

# TEST 5: 8u372 + MaxRAMPercentage=50
docker run --rm --memory=512m --memory-swap=512m \
  oom-test:8u372 -XX:MaxRAMPercentage=50.0 -XX:MaxMetaspaceSize=64m \
  MemorySimulator 2 50 5
결과
TEST 1 — 8u181, Xmx 미설정, 컨테이너 256MB
java.version  : 1.8.0_181
max heap      : 1742 MB        ← 컨테이너는 256MB인데 호스트 기준으로 잡혔다
processors    : 8
cgroup v2 lim : 268435456

[start] launching 12 worker threads

exit code 137 (OOM Killed by cgroup)
max heap 1742MB. 컨테이너의 7배. cgroup이 SIGKILL을 보냈고 JVM 로그는 한 줄도 없다.
TEST 2 — 8u181, -Xmx128m, 동일 컨테이너
java.version  : 1.8.0_181
max heap      : 114 MB

[progress] 30/30 completed, heap=58MB

exit code 0 (정상 완료)
같은 8u181, 같은 256MB 컨테이너. -Xmx128m 하나 추가한 것만 다르다.
TEST 3 — 스레드 수 비교
| 스레드 | 피크 heap | 소요 시간 | |
|---|---|---|---|
| 3a | 2 | 112MB | 1,325ms |
| 3b | 12 | 135MB | 281ms |
-Xmx가 같아도 스레드 수에 따라 피크 메모리가 달라진다. 시뮬레이터에서는 20% 차이인데, 실제 빌드에서 대형 파일의 AST가 동시에 올라가면 차이가 더 벌어진다.
TEST 4 — 8u372, Xmx 미설정, 512MB
java.version  : 1.8.0_372
max heap      : 123 MB         ← 512MB / 4, 컨테이너 기준 산정
cgroup v2 lim : 536870912

[progress] 50/50 completed, heap=35MB

exit code 0 (정상 완료)
Xmx 미설정인데 max heap이 123MB. TEST 1에서 같은 조건으로 1742MB였던 것과 비교하면 JDK 버전 하나 차이다.
TEST 5 — 8u372, MaxRAMPercentage=50, 512MB
java.version  : 1.8.0_372
max heap      : 247 MB         ← 512 * 50%

exit code 0 (정상 완료)
비율 기반 설정이 컨테이너 메모리 기준으로 동작한다.
요약
| 테스트 | JDK | 컨테이너 | -Xmx | max heap | 결과 |
|---|---|---|---|---|---|
| 1 | 8u181 | 256MB | 미설정 | 1,742MB | exit 137 (OOM Kill) |
| 2 | 8u181 | 256MB | 128m | 114MB | exit 0 |
| 3a | 8u181 | 512MB | 256m, 2스레드 | 228MB | exit 0 (피크 112MB) |
| 3b | 8u181 | 512MB | 256m, 12스레드 | 228MB | exit 0 (피크 135MB) |
| 4 | 8u372 | 512MB | 미설정 | 123MB | exit 0 |
| 5 | 8u372 | 512MB | RAMPct=50 | 247MB | exit 0 |
마무리
Java 프로세스가 K8s에서 로그 없이 죽으면, 메모리 누수나 JVM 버그를 의심하기 전에 먼저 볼 것이 있다.
- JDK 버전이 컨테이너 메모리를 인식하는가 (8u191+, cgroup v2라면 8u372+)
- -Xmx가 POD memory limit의 50~60%로 명시되어 있는가
- 멀티스레드 빌드라면 스레드 수가 적절한가
-Xmx를 명시하면 JDK 버전이나 cgroup 버전에 관계없이 동작한다.
참고
- https://github.com/GoogleContainerTools/distroless/issues/324 — JDK 8u181 vs 8u191 컨테이너 인식 차이
- https://www.javaspring.net/blog/do-java-flags-xms-and-xmx-overwrite-flag-xx-usecgroupmemorylimitforheap/ — -Xmx vs cgroup 플래그 우선순위
- https://kubernetes.io/blog/2022/08/31/cgroupv2-ga-1-25/ — K8s cgroup v2 GA, JDK 버전별 지원
- https://access.redhat.com/articles/3735611 — RHEL 8 cgroup v1 기본값
RFC 20 — ASCII: 네트워크 문자 교환의 기초
선수 지식: 이진수와 16진수 표기법, 비트/바이트 개념
RFC 계보: ANSI X3.4-1963 → ANSI X3.4-1968 → RFC 20 (1969, STD 80) → ISO 646 (1991) → Unicode/UTF-8 (RFC 3629)
현행 상태: Internet Standard (STD 80) — 1969년 발행 이후 현재까지 유효한 현행 표준
학습 목표
이 문서를 완료하면 다음을 할 수 있다
- ASCII 코드 테이블의 구조를 설명하고, 임의의 문자의 비트 패턴을 계산할 수 있다.
- 33개 제어 문자의 분류(CC/FE/IS)와 현대 시스템에서의 용도를 설명할 수 있다.
- CR/LF 문제의 역사적 원인과 플랫폼별 차이를 이해하고, 실무에서 진단/변환할 수 있다.
- ASCII와 UTF-8의 호환 관계를 바이트 수준에서 설명할 수 있다.
- 리눅스 시스템에서 인코딩 관련 문제를 진단하고 해결할 수 있다.
1. 배경과 문제 정의
1.1 이 표준이 해결하려는 문제
1969년 ARPANET에 연결된 컴퓨터들은 서로 다른 문자 체계를 사용했다. IBM 메인프레임은 EBCDIC(Extended Binary Coded Decimal Interchange Code), DEC 미니컴퓨터는 자체 문자 집합, CDC 슈퍼컴퓨터는 6비트 Display Code를 사용했다. 워드 크기도 12비트, 16비트, 18비트, 36비트, 60비트 등으로 제각각이었다.
이 환경에서 텍스트 데이터를 교환하려면 모든 시스템이 합의하는 공통 문자 인코딩이 필요했다. 각 시스템은 자체 문자 체계와 공통 인코딩 사이의 변환만 구현하면, N개 시스템 간의 통신이 가능해진다. 이것이 RFC 20이 해결하려는 문제다.
1.2 선행 표준: ANSI X3.4
RFC 20이 채택한 문자 집합은 RFC 자체가 새로 만든 것이 아니다. 미국 표준 협회(ASA, 이후 ANSI)가 1963년에 처음 발행하고 1968년에 개정한 ANSI X3.4-1968(USA Standard Code for Information Interchange)을 네트워크 교환용으로 채택한 것이다.
RFC 20의 핵심 기여는 두 가지다. 첫째, 7비트 문자 코드를 8비트 바이트에 담되 최상위 비트를 항상 0으로 설정하도록 규정했다. 둘째, 이 인코딩을 ARPANET의 Host-Host 통신(NCP 위)에서 사용하는 기본 문자 교환 형식으로 지정했다.
1.3 설계 결정과 트레이드오프
7비트 선택: 128개의 문자를 표현할 수 있다. 당시 영어 알파벳(대소문자), 숫자, 기본 기호, 제어 문자를 담기에 충분했다. 8비트로 확장하면 256개까지 가능하지만, 당시 네트워크 대역폭과 일부 시스템의 7비트 데이터 경로를 고려하면 7비트가 실용적이었다.
8비트 바이트에 7비트 코드: 최상위 비트를 0으로 고정함으로써 7비트 코드를 8비트 바이트 환경에 자연스럽게 임베딩했다. 이 결정은 이후 UTF-8이 ASCII 바이트를 그대로 유지하도록 설계되는 근거가 되었다.
비목표(Non-goal): RFC 20은 물리적 매체에서의 기록 방법, 에러 제어, 코드 확장 기법, 제어 문자의 그래픽 표현을 정의하지 않는다. 이 범위 제한은 의도적인 것으로, 물리적 구현의 다양성을 허용하면서 논리적 문자 집합만 표준화하는 접근이다.
핵심 정리: RFC 20은 새로운 문자 집합을 만든 것이 아니라, 기존 미국 표준(ANSI X3.4-1968)을 네트워크 교환용 기본 인코딩으로 지정한 것이다. 7비트 코드를 8비트 바이트에 담되 최상위 비트를 0으로 고정하는 규칙이 핵심이다.
2. 프로토콜 아키텍처
2.1 계층 내 위치
ASCII는 프로토콜 스택의 특정 계층에 속하는 프로토콜이 아니다. 모든 계층에서 텍스트 데이터를 표현할 때 사용하는 문자 인코딩 표준이다. HTTP 헤더, SMTP 명령어, DNS 도메인 이름, FTP 제어 채널, TLS 핸드셰이크의 SNI 필드 등 인터넷 프로토콜 스택 전반에 걸쳐 사용된다.
flowchart TD
    subgraph app["Application Layer"]
        HTTP
        SMTP
        DNS
    end
    subgraph transport["Transport Layer"]
        TCP
    end
    subgraph encoding["Character Encoding"]
        ASCII["ASCII / UTF-8"]
    end
    SMTP --> TCP
    HTTP --> TCP
    DNS --> TCP
    ASCII -.->|used by| HTTP
    ASCII -.->|used by| SMTP
    ASCII -.->|used by| DNS
    classDef default fill:#FCF8F5,color:#3A2E2C,stroke:#8C5C58,stroke-width:2.2px;
    classDef highlight fill:#BA4E4A,color:#FFFFFF,stroke:#8C5C58,stroke-width:3px;
    class ASCII highlight;
    linkStyle default stroke:#7A6764,stroke-width:2px;
2.2 인접 표준과의 관계
ASCII는 단독으로 존재하지 않는다. 다음 표준들과 밀접한 관계를 맺고 있다.
flowchart TD
  TELE["텔레그래프 코드<br/>1870s Baudot"]
  ITA["5비트 ITA-2<br/>1930s"]
  A63["ANSI X3.4-1963<br/>최초 ASCII"]
  A68["ANSI X3.4-1968<br/>개정판"]
  R20["RFC 20 (1969)<br/>네트워크 교환용 채택"]
  ISO646["ISO 646 (1972)<br/>국제 표준화"]
  ISO8859["ISO 8859-1 (1987)<br/>8비트 확장 Latin-1"]
  WIN1252["Windows-1252<br/>1990s"]
  ISO_SERIES["ISO 8859 시리즈<br/>1-16"]
  UNI["Unicode<br/>1991"]
  UTF8["UTF-8<br/>1993 / RFC 3629"]
  UTF16["UTF-16<br/>RFC 2781"]
  UTF32["UTF-32"]
  TELE --> ITA
  A63 --> A68
  A68 --> R20
  A68 --> ISO646
  ISO646 --> ISO8859
  ISO646 --> ISO_SERIES
  ISO8859 --> WIN1252
  A68 --> UNI
  UNI --> UTF8
  UNI --> UTF16
  UNI --> UTF32
  classDef default fill:#FCF8F5,color:#3A2E2C,stroke:#8C5C58,stroke-width:2.2px;
  classDef highlight fill:#BA4E4A,color:#FFFFFF,stroke:#8C5C58,stroke-width:3px;
  classDef accent fill:#EAD8D5,color:#4A2F2C,stroke:#8C5C58,stroke-width:2.5px;
  class R20,UTF8 highlight;
  class UNI,UTF16,UTF32 accent;
  linkStyle default stroke:#7A6764,stroke-width:2px;
ASCII가 이 계보에서 차지하는 위치는 특별하다. UTF-8이 ASCII의 0x00~0x7F를 1바이트로 그대로 보존하도록 설계되었기 때문에, 유효한 ASCII 텍스트는 동시에 유효한 UTF-8 텍스트이기도 하다. 이 호환성이 UTF-8이 웹의 기본 인코딩이 된 핵심 이유 중 하나다.
핵심 정리: ASCII는 특정 프로토콜 계층에 속하지 않고 모든 계층에서 텍스트를 표현하는 기반이다. UTF-8은 ASCII의 상위 호환으로 설계되어, ASCII 텍스트는 변환 없이 UTF-8로 해석할 수 있다.
3. 메시지 구조: ASCII 코드 테이블
3.1 비트 레이아웃
ASCII는 7비트 코드다. 각 문자는 b7(최상위)부터 b1(최하위)까지 7개 비트로 표현된다. RFC 20은 이를 8비트 바이트에 담을 때 b8(최상위 비트)을 항상 0으로 설정하도록 규정했다.
packet
  0: "0 (항상)"
  1-3: "Column (b7 b6 b5)"
  4-7: "Row (b4 b3 b2 b1)"
Column 번호는 b7, b6, b5의 이진값으로 결정되고(0~7), Row 번호는 b4, b3, b2, b1의 이진값으로 결정된다(0~15). 따라서 128개(8×16) 코드 포인트가 존재한다.
예를 들어 문자 'K'의 코드 포인트는 Column 4, Row 11이다:
- b7=1, b6=0, b5=0 → Column 4
- b4=1, b3=0, b2=1, b1=1 → Row 11
- 7비트 이진: 1001011
- 8비트 바이트: 01001011 = 0x4B = 75(10진수)
3.2 코드 테이블 전체 구조
128개 코드 포인트는 다음과 같이 영역별로 나뉜다.
Column:   0     1     2     3     4     5     6     7
        +-----+-----+-----+-----+-----+-----+-----+-----+
Row  0  | NUL | DLE | SP  |  0  |  @  |  P  |  `  |  p  |
Row  1  | SOH | DC1 |  !  |  1  |  A  |  Q  |  a  |  q  |
Row  2  | STX | DC2 |  "  |  2  |  B  |  R  |  b  |  r  |
Row  3  | ETX | DC3 |  #  |  3  |  C  |  S  |  c  |  s  |
Row  4  | EOT | DC4 |  $  |  4  |  D  |  T  |  d  |  t  |
Row  5  | ENQ | NAK |  %  |  5  |  E  |  U  |  e  |  u  |
Row  6  | ACK | SYN |  &  |  6  |  F  |  V  |  f  |  v  |
Row  7  | BEL | ETB |  '  |  7  |  G  |  W  |  g  |  w  |
Row  8  | BS  | CAN |  (  |  8  |  H  |  X  |  h  |  x  |
Row  9  | HT  | EM  |  )  |  9  |  I  |  Y  |  i  |  y  |
Row 10  | LF  | SUB |  *  |  :  |  J  |  Z  |  j  |  z  |
Row 11  | VT  | ESC |  +  |  ;  |  K  |  [  |  k  |  {  |
Row 12  | FF  | FS  |  ,  |  <  |  L  |  \  |  l  |  |  |
Row 13  | CR  | GS  |  -  |  =  |  M  |  ]  |  m  |  }  |
Row 14  | SO  | RS  |  .  |  >  |  N  |  ^  |  n  |  ~  |
Row 15  | SI  | US  |  /  |  ?  |  O  |  _  |  o  | DEL |
        +-----+-----+-----+-----+-----+-----+-----+-----+
          CC    CC   기호  숫자  대문자 기호  소문자 기호
                           기호        대문자       소문자
영역별 구성:
| Column | 범위 (16진) | 내용 | 개수 |
|---|---|---|---|
| 0 | 0x00~0x0F | 제어 문자 (CC, FE, IS) 전반부 | 16 |
| 1 | 0x10~0x1F | 제어 문자 후반부 | 16 |
| 2 | 0x20~0x2F | 공백(SP) + 기호 | 16 |
| 3 | 0x30~0x3F | 숫자 0~9 + 기호 | 16 |
| 4 | 0x40~0x4F | @ + 대문자 A~O | 16 |
| 5 | 0x50~0x5F | 대문자 P~Z + 기호 | 16 |
| 6 | 0x60~0x6F | ` + 소문자 a~o | 16 |
| 7 | 0x70~0x7F | 소문자 p~z + 기호 + DEL | 16 |
이 배치에는 의도적인 설계가 반영되어 있다.
대소문자 변환이 1비트 연산이다. 대문자 'A'(0x41=01000001)와 소문자 'a'(0x61=01100001)의 차이는 b6 비트 하나뿐이다. 대문자→소문자는 c | 0x20, 소문자→대문자는 c & ~0x20 또는 c & 0xDF로 변환된다. 이 비트 연산은 현대 C 코드에서도 case-insensitive 비교에 사용된다.
숫자 문자와 수치 값의 관계가 직관적이다. 문자 '0'의 코드는 0x30(=48), '9'는 0x39(=57)이다. 문자를 수치로 변환하려면 c - '0'(또는 c - 0x30)만 하면 된다. 이 관계 때문에 C 표준 라이브러리의 atoi(), strtol() 등이 단순하게 구현된다.
정렬 순서가 이진값으로 결정된다. RFC 20 §6.3에서 명시한 규칙이다. 두 문자의 상대적 순서는 이진값으로 결정되며, 이로 인해 숫자(0x30~) < 대문자(0x41~) < 소문자(0x61~) 순서가 된다. strcmp()의 바이트 비교 결과가 ASCII 내에서 일관된 순서를 보장하는 것은 이 설계 덕분이다. 다만 이 순서는 대소문자를 구분하지 않는 사전 순서와는 다르다. case-insensitive 정렬이 필요한 경우 strcasecmp()를 사용해야 한다.
핵심 정리: ASCII 코드 테이블은 단순한 문자-숫자 매핑이 아니다. 대소문자 변환을 1비트 연산으로 만드는 배치, 숫자 문자와 수치의 직관적 대응, 이진값 기반 정렬 순서 등 실용적 설계 결정이 반영되어 있다.
3.3 제어 문자 상세
128개 코드 포인트 중 33개가 제어 문자(0x00~0x1F + 0x7F DEL)이며, 1개가 공백(0x20 SP)이다. RFC 20은 제어 문자를 세 가지 기능 범주로 분류했다.
CC (Communication Control) — 통신 제어
통신 세션의 흐름을 제어하는 문자들이다. 텔레타이프와 모뎀 통신 시대의 산물이며, 현대 TCP/IP 기반 통신에서는 대부분 본래 용도로 사용되지 않는다.
| 코드 | 이름 | 16진 | 원래 용도 | 현대 용도 |
|---|---|---|---|---|
| SOH | Start of Heading | 0x01 | 메시지 헤더 시작 | Ctrl+A (터미널: 줄 시작으로 이동) |
| STX | Start of Text | 0x02 | 메시지 본문 시작 | Ctrl+B (터미널: 커서 뒤로) |
| ETX | End of Text | 0x03 | 메시지 본문 종료 | Ctrl+C (프로세스 인터럽트, SIGINT) |
| EOT | End of Transmission | 0x04 | 전송 종료 | Ctrl+D (EOF 신호, 셸 종료) |
| ENQ | Enquiry | 0x05 | 상대 식별 요청 | Ctrl+E (터미널: 줄 끝으로 이동) |
| ACK | Acknowledge | 0x06 | 수신 확인 | 거의 미사용 |
| DLE | Data Link Escape | 0x10 | 제어 문자 이스케이프 | 거의 미사용 |
| NAK | Negative Acknowledge | 0x15 | 수신 실패 | Ctrl+U (터미널: 줄 삭제) |
| SYN | Synchronous Idle | 0x16 | 동기 회선 유휴 | 거의 미사용 |
| ETB | End of Transmission Block | 0x17 | 전송 블록 종료 | Ctrl+W (터미널: 단어 삭제) |
이 중 현대 리눅스에서 매일 사용하는 것은 ETX(Ctrl+C)와 EOT(Ctrl+D)이다. Ctrl+C가 프로세스를 종료하는 것은 터미널 드라이버가 0x03을 수신하면 포그라운드 프로세스 그룹에 SIGINT 신호를 보내도록 설계되어 있기 때문이다. Ctrl+D는 터미널의 읽기 버퍼를 즉시 플러시하며, 버퍼가 비어있으면 EOF 조건이 되어 셸이 종료된다.
실습 —
stty -a명령으로 현재 터미널의 제어 문자 매핑을 확인해 보자.$ stty -a | grep -E 'intr|eof|erase|kill|susp' intr = ^C; quit = ^\; erase = ^?; kill = ^U; eof = ^D; eol = <undef>; ... susp = ^Z;
intr = ^C는 "인터럽트 문자가 Ctrl+C(0x03, ETX)"임을 의미한다.stty intr ^B로 변경하면 Ctrl+B가 인터럽트 키가 된다.
FE (Format Effector) — 포맷 이펙터
출력 장치(프린터, 디스플레이)의 출력 위치를 제어하는 문자들이다. 현대 시스템에서 가장 활발히 사용되는 제어 문자 범주다.
| 코드 | 이름 | 16진 | 원래 용도 | 현대 용도 |
|---|---|---|---|---|
| BS | Backspace | 0x08 | 인쇄 위치 후퇴 | 백스페이스 키, 터미널 문자 삭제 |
| HT | Horizontal Tab | 0x09 | 수평 탭 | 탭 문자 (\t) — 코드 들여쓰기, TSV 파일 구분자 |
| LF | Line Feed | 0x0A | 종이 한 줄 전진 | Unix/Linux 줄바꿈 (\n) |
| VT | Vertical Tab | 0x0B | 수직 탭 | 거의 미사용 (일부 프린터 제어) |
| FF | Form Feed | 0x0C | 다음 페이지로 이동 | Ctrl+L (터미널 화면 클리어) |
| CR | Carriage Return | 0x0D | 인쇄 위치를 줄 시작으로 | Windows 줄바꿈의 일부 (\r\n), HTTP 헤더 구분 |
이 중 LF와 CR은 현대 컴퓨팅에서 가장 많은 혼란을 일으키는 문자들이다. 이 주제는 §4에서 상세히 다룬다.
HT(수평 탭, 0x09)는 두 가지 논쟁의 원인이다. 첫째, 탭 폭이 표준화되어 있지 않다. 대부분의 시스템은 8칸을 기본으로 사용하지만, 에디터에서는 2칸 또는 4칸으로 설정하는 경우가 많다. 둘째, "탭 vs 스페이스" 논쟁은 프로그래밍 커뮤니티에서 반복적으로 등장하는 주제다. Python은 PEP 8에서 4칸 스페이스를 공식 권장하며, Go는 gofmt에서 탭을 강제한다.
IS (Information Separator) — 정보 분리자
데이터를 논리적 단위로 구분하기 위한 문자들이다. 계층적 관계가 정의되어 있다.
| 코드 | 이름 | 16진 | 계층 | 현대 용도 |
|---|---|---|---|---|
| US | Unit Separator | 0x1F | 최소 단위 | RFC 7464 JSON Text Sequences에서 사용 |
| RS | Record Separator | 0x1E | 레코드 | RFC 7464에서 JSON 시퀀스 구분자로 사용 |
| GS | Group Separator | 0x1D | 그룹 | 일부 바코드 표준(GS1)에서 사용 |
| FS | File Separator | 0x1C | 최대 단위 | 거의 미사용 |
계층 관계는 FS(가장 포괄적) > GS > RS > US(가장 세분화) 순이다. 이 분리자들은 원래 천공 카드와 자기 테이프의 데이터 구조화를 위해 설계되었다. 현대에서는 CSV, TSV, JSON, XML 등 더 풍부한 구조화 형식이 사용되므로 IS 문자들의 직접 사용은 드물다. 다만 RFC 7464(JSON Text Sequences)가 RS(0x1E)를 JSON 시퀀스의 각 항목 시작 구분자로 사용하는 것이 주목할 만한 현대적 사례다.
기타 제어 문자 — 장치 제어, 시프트, 취소
CC/FE/IS 어느 범주에도 속하지 않거나 위 테이블에서 누락된 제어 문자들이다.
| 코드 | 이름 | 16진 | 원래 용도 | 현대 용도 |
|---|---|---|---|---|
| DC1 | Device Control 1 | 0x11 | 장치 제어 | XON — 소프트웨어 흐름 제어에서 전송 재개 (Ctrl+Q) |
| DC2 | Device Control 2 | 0x12 | 장치 제어 | 거의 미사용 |
| DC3 | Device Control 3 | 0x13 | 장치 제어 | XOFF — 소프트웨어 흐름 제어에서 전송 중지 (Ctrl+S) |
| DC4 | Device Control 4 | 0x14 | 장치 제어 (Stop) | 거의 미사용 |
| SO | Shift Out | 0x0E | 대체 문자 집합으로 전환 | 일부 터미널에서 그래픽 문자 모드 전환 |
| SI | Shift In | 0x0F | 기본 문자 집합으로 복귀 | SO의 반대 동작 |
| CAN | Cancel | 0x18 | 현재 데이터 취소 | Ctrl+X (일부 에디터에서 잘라내기) |
| EM | End of Medium | 0x19 | 매체(테이프) 끝 표시 | Ctrl+Y (일부 셸에서 붙여넣기) |
| SUB | Substitute | 0x1A | 무효 문자 대체 | Ctrl+Z — Windows에서 EOF 신호, Unix에서 SIGTSTP(프로세스 일시 정지) |
DC1/DC3(XON/XOFF)는 현대 시스템에서도 실무적으로 중요하다. 터미널에서 Ctrl+S를 실수로 누르면 화면 출력이 멈추는 현상이 발생하는데, 이는 DC3(XOFF)가 전송 중지 신호를 보내기 때문이다. Ctrl+Q(XON)로 해제할 수 있다. 이 동작을 비활성화하려면 stty -ixon을 사용한다.
SUB(0x1A)는 Unix와 Windows에서 완전히 다른 의미로 사용된다. Windows에서는 텍스트 파일의 EOF 표시로, Unix에서는 SIGTSTP 신호(프로세스 일시 정지, fg로 재개 가능)로 사용된다. 크로스 플랫폼 개발 시 이 차이를 인식해야 한다.
특수 문자
| 코드 | 이름 | 16진 | 설명 |
|---|---|---|---|
| NUL | Null | 0x00 | 모든 비트가 0. C 언어에서 문자열 종료자(\0). 천공 테이프에서는 "구멍 없음" 상태 |
| BEL | Bell | 0x07 | 터미널 경고음. echo -e '\a'로 확인 가능. 현대에서는 GUI 알림으로 대체 |
| ESC | Escape | 0x1B | 코드 확장용 접두 문자. ANSI 이스케이프 시퀀스(ESC[로 시작)의 기반. 터미널 색상, 커서 제어에 현재도 사용 |
| DEL | Delete | 0x7F | 천공 테이프에서 모든 구멍을 뚫어 기존 문자를 무효화. b1~b7 모두 1인 유일한 문자. 현대에서는 Delete 키에 매핑 |
| SP | Space | 0x20 | 공백. 기술적으로는 제어 문자가 아니라 인쇄 문자이나, "보이지 않는 문자"로서 제어 문자와 인쇄 문자의 경계에 있다 |
NUL(0x00)의 C 언어에서의 역할은 특히 중요하다. C 문자열은 NUL로 종료되며(char *s = "hello"는 메모리에 68 65 6C 6C 6F 00으로 저장), strlen(), strcpy() 등의 함수가 NUL을 문자열 끝으로 인식한다. 이 설계는 바이너리 데이터에 NUL이 포함될 경우 문자열 함수가 데이터를 잘라내는 문제를 야기하며, 이것이 바이너리 안전(binary-safe) 함수가 별도로 필요한 이유다.
ESC(0x1B)는 현대 터미널에서 여전히 핵심적으로 사용된다. ANSI 이스케이프 시퀀스는 ESC[ (0x1B 0x5B)로 시작하며, 텍스트 색상 변경(\033[31m = 빨간색), 커서 이동(\033[H = 홈 위치), 화면 클리어(\033[2J) 등을 수행한다. ls --color, git diff, htop 등 색상이 있는 CLI 도구는 모두 이 메커니즘에 의존한다.
핵심 정리: ASCII의 33개 제어 문자 중 현대 시스템에서 일상적으로 사용되는 것은 LF, CR, HT, BS, NUL, ESC, ETX(Ctrl+C), EOT(Ctrl+D), SUB(Ctrl+Z, Windows EOF) 정도다. 나머지는 원래 용도와 다른 의미로 재활용되거나 사실상 사용되지 않는다.
4. 프로토콜 동작: CR/LF 문제
4.1 역사적 배경
CR/LF 문제는 ASCII에서 가장 실무적으로 중요한 주제다. 이 문제의 근원은 기계적 텔레타이프에 있다.
텔레타이프(특히 Teletype Model 33 ASR)에서 줄바꿈은 두 단계의 물리적 동작이 필요했다. CR(Carriage Return, 0x0D) 은 인쇄 캐리지를 줄의 시작 위치로 되돌리는 동작이다. LF(Line Feed, 0x0A) 는 종이를 한 줄 위로 올리는 동작이다. 두 동작을 합쳐야 비로소 "다음 줄의 시작"에 도달한다.
여기서 중요한 물리적 제약이 있었다. 캐리지가 오른쪽 끝에서 왼쪽 시작으로 되돌아오는 데 시간이 걸렸다. CR 직후 즉시 문자를 출력하면 캐리지가 아직 이동 중이므로 줄 중간에 문자가 찍히는 현상(smudge)이 발생했다. 이 때문에 CR 뒤에 LF를 보내어 캐리지 복귀 시간을 확보하거나, CR 뒤에 NUL(0x00)을 padding으로 삽입하는 관행이 있었다.
4.2 플랫폼별 줄바꿈 규칙
이 물리적 유산이 세 가지 서로 다른 줄바꿈 규칙으로 분화되었다.
| 플랫폼 | 줄바꿈 문자 | 16진 | C 이스케이프 | 유래 |
|---|---|---|---|---|
| Unix/Linux/macOS | LF | 0x0A | \n |
Multics → Unix 계보. 단일 문자로 단순화 |
| Windows/DOS | CR+LF | 0x0D 0x0A | \r\n |
CP/M → DOS → Windows 계보. 텔레타이프 관행 유지 |
| Classic Mac OS (pre-X) | CR | 0x0D | \r |
Apple의 독자적 선택. OS X에서 LF로 전환 |
네트워크 프로토콜(HTTP, SMTP, FTP, Telnet)은 CR+LF를 줄바꿈으로 사용한다. 이는 Telnet의 NVT(Network Virtual Terminal) 정의(RFC 854)에서 네트워크 줄바꿈을 CR+LF로 명시한 것에 기인하며, NVT의 문자 집합이 RFC 20의 ASCII를 기반으로 했기 때문이다. 이후의 모든 텍스트 기반 인터넷 프로토콜이 NVT의 줄바꿈 규칙을 계승했다.
4.3 실제 문제 시나리오
시나리오 1: Windows에서 작성한 스크립트를 Linux에서 실행
$ cat -A script.sh
#!/bin/bash^M
echo "hello"^M
^M은 CR(0x0D)의 표시다. bash가 이 스크립트를 실행하면 #!/bin/bash\r을 인터프리터 경로로 해석하여 /bin/bash\r이라는 파일을 찾으려 하고, 존재하지 않으므로 실패한다. 에러 메시지는 bad interpreter: No such file or directory로, CR 문자가 보이지 않으므로 원인을 파악하기 어렵다.
# 진단
$ file script.sh
script.sh: Bash script, ASCII text executable, with CRLF line terminators

# 수정
$ dos2unix script.sh
dos2unix: converting file script.sh to Unix format...

# 또는 sed로 직접 제거
$ sed -i 's/\r$//' script.sh
시나리오 2: Git에서의 줄바꿈 충돌
Windows와 Linux 개발자가 같은 저장소에서 작업할 때, Git이 체크아웃/커밋 시 줄바꿈을 변환하면서 불필요한 diff가 발생한다.
# Git 줄바꿈 설정 확인
$ git config --global core.autocrlf
# Linux에서 권장: input (커밋 시 CRLF→LF, 체크아웃 시 변환 없음)
# Windows에서 권장: true (커밋 시 CRLF→LF, 체크아웃 시 LF→CRLF)

# 프로젝트별 설정 (.gitattributes)
$ cat .gitattributes
* text=auto
*.sh text eol=lf
*.bat text eol=crlf
*.png binary
시나리오 3: HTTP 헤더 파싱
HTTP/1.1(RFC 7230)은 헤더 줄을 CR+LF로 구분하고, 헤더와 본문 사이를 빈 줄(CR+LF+CR+LF)로 구분한다. 일부 서버는 관용적으로 LF만으로도 헤더를 구분하지만, 엄격한 구현은 CR+LF만 인정한다.
GET / HTTP/1.1\r\n
Host: example.com\r\n
Accept: text/html\r\n
\r\n
(본문 시작)
이 4바이트 시퀀스(0x0D 0x0A 0x0D 0x0A)가 헤더 종료를 나타낸다. HTTP 파서에서 이 시퀀스를 감지하지 못하면 헤더와 본문을 구분할 수 없다.
시나리오 4: SMTP 스머글링
2023년에 발견된 SMTP smuggling 공격은 메일 서버들이 bare LF(CR 없는 LF)를 처리하는 방식의 차이를 악용했다. RFC 5321은 SMTP에서 줄바꿈이 반드시 CR+LF여야 한다고 규정하지만, 일부 서버는 bare LF도 줄바꿈으로 인정했다. 공격자는 이 불일치를 이용하여 SPF/DKIM 인증을 우회하는 이메일을 전송할 수 있었다.
핵심 정리: CR/LF 문제는 1960년대 텔레타이프의 물리적 제약에서 시작되어, 운영체제 간 줄바꿈 규칙 차이, 네트워크 프로토콜의 줄바꿈 표준, 그리고 2023년의 SMTP 보안 취약점에까지 이르는 60년 역사의 문제다. 핵심은 "줄바꿈이 CR+LF인지 LF인지"를 항상 의식하는 것이다.
5. 리눅스 구현과 실무
5.1 커널 및 시스템 설정
리눅스 시스템에서 ASCII와 관련된 주요 설정:
로케일 설정: 시스템의 문자 인코딩은 로케일로 결정된다.
# 현재 로케일 확인
$ locale
LANG=en_US.UTF-8
LC_CTYPE="en_US.UTF-8"
...

# 사용 가능한 로케일 목록
$ locale -a | grep -i utf
en_US.utf8
ko_KR.utf8
...

# C 로케일은 순수 ASCII만 사용
$ LC_ALL=C locale charmap
ANSI_X3.4-1968
LC_ALL=C(또는 LANG=C)로 설정하면 시스템이 순수 ASCII 모드로 동작한다. 이 상태에서는 0x80 이상의 바이트가 유효한 문자로 인식되지 않는다. 스크립트에서 바이트 단위 처리가 필요하거나, 로케일 의존적 동작을 피하려 할 때 LC_ALL=C를 명시적으로 사용한다.
터미널 제어 문자 매핑: stty 명령으로 확인/변경한다.
# 모든 제어 문자 매핑 확인
$ stty -a
speed 38400 baud; rows 24; columns 80;
intr = ^C; quit = ^\; erase = ^?; kill = ^U;
eof = ^D; eol = <undef>; start = ^Q; stop = ^S;
susp = ^Z; ...

# Ctrl+C의 매핑을 Ctrl+X로 변경 (권장하지 않지만 가능)
$ stty intr ^X
5.2 CLI 도구 실습
xxd — 바이트 수준 확인: 파일의 실제 바이트 내용을 16진수로 확인한다.
# "Hello\n"의 실제 바이트 확인
$ echo "Hello" | xxd
00000000: 4865 6c6c 6f0a                           Hello.

# Windows 줄바꿈 파일의 바이트 확인
$ printf "Hello\r\n" | xxd
00000000: 4865 6c6c 6f0d 0a                        Hello..
0x0A는 LF, 0x0D는 CR이다. xxd 출력에서 .으로 표시되는 문자는 인쇄 불가능한 문자(제어 문자)를 나타낸다.
file — 파일 인코딩 및 줄바꿈 감지:
$ file *.txt
unix_file.txt:    ASCII text
windows_file.txt: ASCII text, with CRLF line terminators
utf8_file.txt:    UTF-8 Unicode text
binary_file.dat:  data
od — 8진수/16진수 덤프:
# 문자별 코드 포인트 확인
$ echo -n "AaBb" | od -A x -t x1z
000000 41 61 42 62                                  >AaBb<
iconv — 인코딩 변환:
# EUC-KR → UTF-8 변환
$ iconv -f EUC-KR -t UTF-8 input.txt > output.txt

# 변환 불가능한 문자를 '?'로 대체
$ iconv -f UTF-8 -t ASCII//TRANSLIT input.txt > ascii_only.txt
tr — 제어 문자 제거/변환:
# CR 문자 제거 (dos2unix 대체)
$ tr -d '\r' < windows.txt > unix.txt

# 인쇄 불가능 문자를 모두 제거
$ tr -cd '[:print:]\n' < dirty.txt > clean.txt
hexdump — HTTP 응답의 바이트 확인:
# HTTP 응답 헤더의 실제 줄바꿈 확인
$ curl -sI https://example.com | xxd | head -5
00000000: 4854 5450 2f31 2e31 2032 3030 204f 4b0d  HTTP/1.1 200 OK.
00000010: 0a44 6174 653a 2046 7269 2c20 3031 204d  .Date: Fri, 01 M
마지막 바이트 0d(CR)와 다음 줄 시작 0a(LF)가 HTTP 줄바꿈(CR+LF)을 구성하고 있음을 확인할 수 있다.
5.3 ASCII 관련 커널 메커니즘
TTY 라인 디시플린(Line Discipline): 리눅스 커널의 TTY 서브시스템은 ASCII 제어 문자를 해석하여 특정 동작을 수행한다. 이 처리는 n_tty.c(N_TTY 라인 디시플린)에서 이루어진다.
# cooked 모드(기본): 커널이 제어 문자를 해석
# raw 모드: 커널이 제어 문자를 해석하지 않고 그대로 전달
$ stty raw    # raw 모드 전환 (Ctrl+C도 작동하지 않게 됨)
$ stty cooked # 복원
cooked 모드에서 커널이 해석하는 주요 제어 문자:
- 0x03 (Ctrl+C) → SIGINT 전송
- 0x1A (Ctrl+Z) → SIGTSTP 전송 (프로세스 일시 정지)
- 0x04 (Ctrl+D) → EOF 조건 생성
- 0x08 (Ctrl+H) 또는 0x7F (DEL) → 문자 삭제 (erase)
- 0x15 (Ctrl+U) → 줄 삭제 (kill)
핵심 정리: 리눅스에서 ASCII는 로케일(
LANG,LC_*), 터미널 드라이버(stty), TTY 라인 디시플린(n_tty.c)의 세 수준에서 처리된다.xxd,file,iconv,tr등의 CLI 도구로 인코딩 문제를 진단한다.
6. 코드 예제
6.1 C: ASCII 문자 분류기와 변환기
다음 프로그램은 ASCII 코드 테이블의 구조를 실제 코드로 확인한다. 문자의 분류, 대소문자 변환(비트 연산), 숫자 문자→정수 변환을 수행한다.
/* ascii_inspector.c
 * ASCII 문자 검사 및 변환 도구
 * 컴파일: gcc -o ascii_inspector ascii_inspector.c -Wall -Wextra
 * 사용:   echo "Hello, World! 123" | ./ascii_inspector
 */
#include <stdio.h>
#include <stdlib.h>
#include <ctype.h>

static const char *classify_control(unsigned char c) {
    /* RFC 20의 제어 문자 분류 */
    switch (c) {
        case 0x00: return "NUL (Null)";
        case 0x01: return "SOH (Start of Heading) [CC]";
        case 0x02: return "STX (Start of Text) [CC]";
        case 0x03: return "ETX (End of Text) [CC] — Ctrl+C";
        case 0x04: return "EOT (End of Transmission) [CC] — Ctrl+D";
        case 0x07: return "BEL (Bell)";
        case 0x08: return "BS  (Backspace) [FE]";
        case 0x09: return "HT  (Horizontal Tab) [FE]";
        case 0x0A: return "LF  (Line Feed) [FE] — Unix newline";
        case 0x0B: return "VT  (Vertical Tab) [FE]";
        case 0x0C: return "FF  (Form Feed) [FE]";
        case 0x0D: return "CR  (Carriage Return) [FE]";
        case 0x1B: return "ESC (Escape) — ANSI sequence prefix";
        case 0x1C: return "FS  (File Separator) [IS]";
        case 0x1D: return "GS  (Group Separator) [IS]";
        case 0x1E: return "RS  (Record Separator) [IS]";
        case 0x1F: return "US  (Unit Separator) [IS]";
        case 0x7F: return "DEL (Delete)";
        default:   return "(other control)";
    }
}

int main(void) {
    int ch;
    int count = 0;

    printf("%-6s %-4s %-8s %-10s %-30s\n",
           "Char", "Dec", "Hex", "Binary", "Classification");
    printf("------+----+--------+----------+------------------------------\n");

    while ((ch = getchar()) != EOF) {
        unsigned char c = (unsigned char)ch;

        /* 8비트 이진 표현 */
        char binary[9];
        for (int i = 7; i >= 0; i--) {
            binary[7 - i] = (c >> i) & 1 ? '1' : '0';
        }
        binary[8] = '\0';

        /* 표시용 문자 */
        char display[5];
        if (c < 0x20 || c == 0x7F) {
            snprintf(display, sizeof(display), "^%c", c < 0x20 ? c + 0x40 : '?');
        } else {
            snprintf(display, sizeof(display), "'%c'", c);
        }

        /* 분류 */
        const char *classification;
        if (c < 0x20 || c == 0x7F) {
            classification = classify_control(c);
        } else if (c == 0x20) {
            classification = "SP (Space)";
        } else if (c >= '0' && c <= '9') {
            /* 숫자→정수 변환: 0x30 빼기 */
            int val = c - '0'; /* 또는 c - 0x30 */
            static char buf[64];
            snprintf(buf, sizeof(buf), "Digit (numeric value: %d)", val);
            classification = buf;
        } else if (c >= 'A' && c <= 'Z') {
            /* 대→소 변환: bit 5 설정 (OR 0x20) */
            char lower = c | 0x20;
            static char buf[64];
            snprintf(buf, sizeof(buf), "Uppercase (lowercase: '%c' via |0x20)", lower);
            classification = buf;
        } else if (c >= 'a' && c <= 'z') {
            /* 소→대 변환: bit 5 클리어 (AND 0xDF) */
            char upper = c & 0xDF;
            static char buf[64];
            snprintf(buf, sizeof(buf), "Lowercase (uppercase: '%c' via &0xDF)", upper);
            classification = buf;
        } else if (c > 0x7F) {
            classification = "Non-ASCII (outside RFC 20 range)";
        } else {
            classification = "Symbol/Punctuation";
        }

        printf("%-6s %-4d 0x%02X     %s   %s\n",
               display, c, c, binary, classification);
        count++;
    }

    printf("\nTotal: %d bytes processed\n", count);
    return 0;
}
실행 예:
$ echo -n "Ab9\r\n" | ./ascii_inspector
Char   Dec  Hex      Binary     Classification
------+----+--------+----------+------------------------------
'A'    65   0x41     01000001   Uppercase (lowercase: 'a' via |0x20)
'b'    98   0x62     01100010   Lowercase (uppercase: 'B' via &0xDF)
'9'    57   0x39     00111001   Digit (numeric value: 9)
^M     13   0x0D     00001101   CR  (Carriage Return) [FE]
^J     10   0x0A     00001010   LF  (Line Feed) [FE] — Unix newline

Total: 5 bytes processed
6.2 Python: 인코딩 변환 및 CR/LF 정규화 도구
#!/usr/bin/env python3
"""ascii_normalize.py — 파일의 인코딩과 줄바꿈을 검사하고 정규화한다.

사용법:
    python3 ascii_normalize.py [--fix] <filename>
    python3 ascii_normalize.py --fix --target-eol lf input.txt
"""
import sys
import argparse
from pathlib import Path


def analyze_file(filepath: str) -> dict:
    """파일의 인코딩 특성을 분석한다."""
    data = Path(filepath).read_bytes()

    result = {
        'total_bytes': len(data),
        'ascii_bytes': 0,
        'non_ascii_bytes': 0,
        'control_chars': {},
        'cr_count': 0,
        'lf_count': 0,
        'crlf_count': 0,
        'bare_cr_count': 0,
        'bare_lf_count': 0,
        'nul_count': 0,
        'is_pure_ascii': True,
    }

    i = 0
    while i < len(data):
        b = data[i]
        if b > 0x7F:
            result['non_ascii_bytes'] += 1
            result['is_pure_ascii'] = False
        else:
            result['ascii_bytes'] += 1

        if b == 0x00:
            result['nul_count'] += 1

        if b == 0x0D:  # CR
            result['cr_count'] += 1
            if i + 1 < len(data) and data[i + 1] == 0x0A:
                result['crlf_count'] += 1
                i += 1  # skip the LF that's part of CRLF
            else:
                result['bare_cr_count'] += 1
        elif b == 0x0A:  # LF (not preceded by CR)
            result['lf_count'] += 1
            result['bare_lf_count'] += 1
        elif b < 0x20 and b not in (0x09, 0x0A, 0x0D):
            # 비정상적 제어 문자 (HT, LF, CR 제외)
            name = {
                0x00: 'NUL', 0x01: 'SOH', 0x02: 'STX', 0x03: 'ETX',
                0x04: 'EOT', 0x07: 'BEL', 0x08: 'BS', 0x0B: 'VT',
                0x0C: 'FF', 0x1B: 'ESC', 0x1C: 'FS', 0x1D: 'GS',
                0x1E: 'RS', 0x1F: 'US',
            }.get(b, f'0x{b:02X}')
            result['control_chars'][name] = result['control_chars'].get(name, 0) + 1

        i += 1

    # 줄바꿈 방식 판정
    if result['crlf_count'] > 0 and result['bare_lf_count'] == 0:
        result['eol_style'] = 'CRLF (Windows)'
    elif result['bare_lf_count'] > 0 and result['crlf_count'] == 0:
        result['eol_style'] = 'LF (Unix)'
    elif result['bare_cr_count'] > 0 and result['crlf_count'] == 0 and result['bare_lf_count'] == 0:
        result['eol_style'] = 'CR (Classic Mac)'
    elif result['crlf_count'] > 0 and result['bare_lf_count'] > 0:
        result['eol_style'] = 'MIXED (CRLF + LF) — 문제 있음!'
    else:
        result['eol_style'] = 'None (단일 줄)'

    return result


def normalize_eol(filepath: str, target: str = 'lf') -> int:
    """줄바꿈을 지정된 형식으로 정규화한다."""
    data = Path(filepath).read_bytes()

    # 먼저 모든 CRLF를 LF로 통일
    normalized = data.replace(b'\r\n', b'\n')
    # 남은 bare CR도 LF로 변환
    normalized = normalized.replace(b'\r', b'\n')

    if target == 'crlf':
        normalized = normalized.replace(b'\n', b'\r\n')

    Path(filepath).write_bytes(normalized)
    return len(data) - len(normalized)


def main():
    parser = argparse.ArgumentParser(description='ASCII/인코딩 분석 및 정규화')
    parser.add_argument('filename', help='분석할 파일')
    parser.add_argument('--fix', action='store_true', help='줄바꿈 정규화 수행')
    parser.add_argument('--target-eol', choices=['lf', 'crlf'], default='lf',
                        help='정규화 대상 줄바꿈 (기본: lf)')
    args = parser.parse_args()

    result = analyze_file(args.filename)

    print(f"File: {args.filename}")
    print(f"Size: {result['total_bytes']} bytes")
    print(f"ASCII bytes: {result['ascii_bytes']} ({result['ascii_bytes']*100//max(result['total_bytes'],1)}%)")
    print(f"Non-ASCII bytes: {result['non_ascii_bytes']}")
    print(f"Pure ASCII: {'Yes' if result['is_pure_ascii'] else 'No'}")
    print(f"EOL style: {result['eol_style']}")
    print(f"  CRLF: {result['crlf_count']}, Bare LF: {result['bare_lf_count']}, "
          f"Bare CR: {result['bare_cr_count']}")

    if result['nul_count'] > 0:
        print(f"  WARNING: {result['nul_count']} NUL bytes found (binary file?)")
    if result['control_chars']:
        print(f"  Unusual control chars: {result['control_chars']}")

    if args.fix:
        diff = normalize_eol(args.filename, args.target_eol)
        target_name = 'LF' if args.target_eol == 'lf' else 'CRLF'
        print(f"\nNormalized to {target_name} (size change: {diff} bytes)")


if __name__ == '__main__':
    main()
실행 예:
$ python3 ascii_normalize.py mixed_eol_file.txt
File: mixed_eol_file.txt
Size: 1247 bytes
ASCII bytes: 1247 (100%)
Non-ASCII bytes: 0
Pure ASCII: Yes
EOL style: MIXED (CRLF + LF) — 문제 있음!
  CRLF: 12, Bare LF: 34, Bare CR: 0

$ python3 ascii_normalize.py --fix --target-eol lf mixed_eol_file.txt
Normalized to LF (size change: -12 bytes)
핵심 정리: C에서 ASCII의 대소문자 변환은 비트 연산(
| 0x20,& 0xDF)으로 수행할 수 있다. 인코딩 문제 진단/정규화 도구는 바이트 수준에서 동작해야 하며, 텍스트 모드('r')가 아닌 바이너리 모드('rb')로 파일을 읽어야 플랫폼 의존적 줄바꿈 변환을 피할 수 있다.
7. 트러블슈팅
7.1 "Bad interpreter" 에러
증상: Linux에서 셸 스크립트 실행 시 bash: ./script.sh: /bin/bash^M: bad interpreter: No such file or directory 에러 발생.
원인: 스크립트 파일이 Windows에서 작성되어 shebang 줄(#!/bin/bash)이 #!/bin/bash\r로 저장되었다. \r(CR, 0x0D)이 인터프리터 경로의 일부로 해석되어 존재하지 않는 파일을 찾는다.
진단:
$ file script.sh
script.sh: Bash script, ASCII text executable, with CRLF line terminators

$ head -1 script.sh | xxd
00000000: 2321 2f62 696e 2f62 6173 680d 0a         #!/bin/bash..
                                       ^^^^
                                       CR (0x0D) 이 문제
해결:
$ dos2unix script.sh
# 또는
$ sed -i 's/\r$//' script.sh
# 또는 vim에서
:set fileformat=unix
:wq
7.2 인코딩 불일치로 인한 한글 깨짐
증상: EUC-KR로 작성된 파일을 UTF-8 터미널에서 열면 한글이 깨져서 표시된다. 또는 그 반대.
원인: 파일의 실제 인코딩과 터미널/에디터의 기대 인코딩이 다르다.
진단:
# 파일 인코딩 추정 (정확하지 않을 수 있음)
$ file --mime-encoding document.txt
document.txt: euc-kr

# chardet으로 더 정확한 추정 (pip install chardet)
$ chardetect document.txt
document.txt: EUC-KR with confidence 0.99

# 실제 바이트 확인
$ xxd document.txt | head -3
해결:
# EUC-KR → UTF-8 변환
$ iconv -f EUC-KR -t UTF-8 document.txt > document_utf8.txt

# 변환 불가능한 문자가 있으면 에러 발생. 무시하려면:
$ iconv -f EUC-KR -t UTF-8//IGNORE document.txt > document_utf8.txt
7.3 Git diff에서 모든 줄이 변경된 것으로 표시
증상: 내용을 변경하지 않았는데 git diff에서 파일 전체가 변경된 것으로 표시된다.
원인: core.autocrlf 설정에 의해 체크아웃 시 줄바꿈이 변환되었거나, 에디터가 줄바꿈 형식을 변경했다.
진단:
# 줄바꿈 변경 여부 확인
$ git diff --name-only
file.txt

$ git diff file.txt | head -10
# 모든 줄에 줄바꿈 변경만 보이면 CR/LF 문제

# 현재 autocrlf 설정 확인
$ git config core.autocrlf
해결:
# .gitattributes로 프로젝트 수준에서 해결 (권장)
$ cat > .gitattributes << 'EOF'
* text=auto
*.sh text eol=lf
*.py text eol=lf
*.bat text eol=crlf
*.png binary
*.jpg binary
EOF

# 이미 커밋된 파일의 줄바꿈 정규화
$ git add --renormalize .
$ git commit -m "Normalize line endings"
7.4 curl/wget 응답 파싱 시 헤더 끝 감지 실패
증상: HTTP 응답을 파싱할 때 헤더와 본문의 경계를 찾지 못한다.
원인: 헤더 종료를 \n\n으로 검색하고 있지만, HTTP 표준은 \r\n\r\n을 사용한다.
진단:
# 실제 헤더 종료 바이트 확인
$ curl -sI https://example.com | xxd | grep "0d0a 0d0a"
해결: 헤더 파싱 시 \r\n\r\n을 사용하되, 관용적으로 \n\n도 허용하는 것이 실무적이다 (RFC 7230 §3.5 "robustness principle" 참조).
# 관용적 헤더/본문 분리
def split_http_response(raw: bytes) -> tuple:
    # 먼저 표준(CRLF) 시도
    sep = b'\r\n\r\n'
    idx = raw.find(sep)
    if idx >= 0:
        return raw[:idx], raw[idx + len(sep):]
    # 폴백: bare LF
    sep = b'\n\n'
    idx = raw.find(sep)
    if idx >= 0:
        return raw[:idx], raw[idx + len(sep):]
    # 구분자 없음
    return raw, b''
핵심 정리: ASCII 관련 트러블슈팅의 핵심 도구는
xxd(바이트 수준 확인),file(인코딩/줄바꿈 감지),dos2unix(줄바꿈 변환),iconv(인코딩 변환)이다. 문제의 원인은 대부분 "보이지 않는 문자"(CR, BOM, NUL)이므로 바이트 수준 확인이 필수다.
7.5 UTF-8 BOM으로 인한 파싱 에러
증상: UTF-8로 저장한 설정 파일이나 셸 스크립트가 올바른 내용인데도 파싱 에러를 일으킨다. JSON 파일의 경우 Unexpected token 에러가 발생하고, 셸 스크립트의 경우 shebang이 인식되지 않는다.
원인: Windows 메모장(Notepad)이 UTF-8 파일 저장 시 파일 시작에 BOM(Byte Order Mark, 0xEF 0xBB 0xBF)을 자동 삽입한다. UTF-8에서 BOM은 바이트 순서 표시의 기능이 없으므로(UTF-8은 바이트 순서가 고정) 불필요하지만, 일부 Windows 프로그램이 인코딩 식별 목적으로 삽입한다. Unix 도구 대부분은 BOM을 기대하지 않으며, 이를 일반 데이터로 처리하여 파싱에 실패한다.
진단:
# BOM 존재 여부 확인
$ xxd config.json | head -1
00000000: efbb bf7b 0a20 2022 6e61 6d65 223a       ...{. "name":
           ^^^^^^^^
           UTF-8 BOM (0xEF 0xBB 0xBF)

$ file config.json
config.json: UTF-8 Unicode (with BOM) text
해결:
# BOM 제거 (sed)
$ sed -i '1s/^\xEF\xBB\xBF//' config.json

# BOM 제거 (tail — 3바이트 건너뛰기, 대용량 파일에 부적합)
$ tail -c +4 config.json > config_no_bom.json

# 디렉토리 내 모든 파일에서 BOM 일괄 제거
$ find . -type f -name "*.json" -exec sed -i '1s/^\xEF\xBB\xBF//' {} +
8. RFC 계보와 현대 발전
8.1 ASCII에서 UTF-8까지
%%{init: {'theme': 'base', 'themeVariables': {'cScale0': '#EAD8D5', 'cScale1': '#BA4E4A', 'cScale2': '#EAD8D5', 'cScale3': '#BA4E4A', 'cScaleLabel0': '#3A2E2C', 'cScaleLabel1': '#FFFFFF', 'cScaleLabel2': '#3A2E2C', 'cScaleLabel3': '#FFFFFF', 'cScalePeer0': '#FCF8F5', 'cScalePeer1': '#FCF8F5', 'cScalePeer2': '#FCF8F5', 'cScalePeer3': '#FCF8F5'}}}%%
timeline
  title 문자 인코딩 표준의 발전
  section ASCII 태동
    1963 : ANSI X3.4-1963 — First ASCII Standard
    1967 : ANSI X3.4-1967
    1968 : ANSI X3.4-1968 — Revised 7-bit ASCII
  section 네트워크 채택
    1969 : RFC 20 — ASCII for Network Interchange
    1972 : ISO 646 — International Standardization
  section 8비트 확장과 Unicode
    1987 : ISO 8859-1 — 8-bit Latin Extension
    1991 : Unicode 1.0
    1993 : UTF-8 Designed (Thompson, Pike)
  section 현행 표준 확정
    1998 : RFC 2279 — First UTF-8 RFC
    2003 : RFC 3629 — UTF-8 Current Standard (STD 63)
    2015 : RFC 20 Promoted to Internet Standard (STD 80)
ASCII의 한계와 확장 시도: ASCII는 영어 알파벳만 지원한다. 유럽어의 악센트 문자(é, ü, ñ), 아시아 문자(한글, 한자, 가나)를 표현할 수 없다. 이 문제를 해결하기 위해 여러 확장이 시도되었다.
ISO 8859 시리즈: 8비트로 확장하여 0x80~0xFF에 추가 문자를 배치했다. ISO 8859-1(Latin-1)은 서유럽어, ISO 8859-2는 동유럽어 등 지역별로 다른 코드 페이지를 정의했다. 문제는 하나의 파일에서 여러 언어를 동시에 사용할 수 없다는 것이다.
EUC-KR / Shift_JIS / Big5: 동아시아 문자를 위한 멀티바이트 인코딩. 각 언어별로 독자적인 인코딩이 존재하여 호환성 문제가 심각했다.
Unicode와 UTF-8: Unicode는 세계의 모든 문자를 하나의 코드 포인트 체계에 통합했다. UTF-8은 Unicode 코드 포인트를 가변 길이 바이트 시퀀스로 인코딩하며, ASCII 호환성을 보장한다.
8.2 UTF-8의 ASCII 호환성
UTF-8이 ASCII와 호환되는 구조:
바이트 수   코드 포인트 범위          바이트 패턴
1바이트     U+0000 ~ U+007F (ASCII)   0xxxxxxx
2바이트     U+0080 ~ U+07FF           110xxxxx 10xxxxxx
3바이트     U+0800 ~ U+FFFF           1110xxxx 10xxxxxx 10xxxxxx
4바이트     U+10000 ~ U+10FFFF        11110xxx 10xxxxxx 10xxxxxx 10xxxxxx
1바이트 인코딩(0xxxxxxx)이 정확히 ASCII의 7비트 코드에 최상위 비트 0을 붙인 형태다. 따라서 유효한 ASCII 텍스트는 바이트 수준에서 변환 없이 유효한 UTF-8 텍스트이기도 하다.
이 설계에는 중요한 특성이 있다. 멀티바이트 시퀀스의 후속 바이트(10xxxxxx, 0x80~0xBF)는 ASCII 범위(0x00~0x7F)와 겹치지 않는다. 따라서 ASCII 문자를 찾는 바이트 검색(예: strchr(s, '/'))이 멀티바이트 문자 중간을 잘못 매칭하는 일이 없다. UTF-8이 Shift_JIS 같은 기존 멀티바이트 인코딩보다 안전한 결정적 이유다.
8.3 현대 프로토콜에서의 ASCII
현행 인터넷 프로토콜에서 ASCII가 사용되는 방식:
| 프로토콜 | ASCII 사용 영역 | 비ASCII 데이터 처리 |
|---|---|---|
| HTTP/1.1 (RFC 7230) | 헤더 이름/값, 메소드, URI | 본문은 Content-Type 인코딩 사용 |
| SMTP (RFC 5321) | 명령어, 주소 | MIME(RFC 2045)로 본문 인코딩 |
| DNS (RFC 1035) | 도메인 라벨 | IDN(RFC 5891)으로 유니코드 도메인 처리 |
| FTP (RFC 959) | 제어 채널 명령어 | 데이터 채널은 별도 |
| TLS (RFC 8446) | SNI(Server Name Indication) | — |
| JSON (RFC 8259) | 키/값(UTF-8 기본) | \uXXXX 이스케이프 |
| URI (RFC 3986) | 경로, 쿼리 | 비ASCII → %XX 퍼센트 인코딩 |
핵심 정리: ASCII는 UTF-8의 진부분집합이다. UTF-8은 ASCII 호환성을 핵심 설계 제약으로 삼았으며, 이것이 UTF-8이 웹의 기본 인코딩이 된 결정적 이유다. 현대 인터넷 프로토콜은 제어 채널/헤더에서 여전히 ASCII를 사용하며, 비ASCII 데이터는 별도의 인코딩 메커니즘(MIME, IDN, 퍼센트 인코딩)으로 처리한다.
용어집
| 용어 | 설명 |
|---|---|
| ASCII | 7비트 문자 인코딩 표준. 128개 코드 포인트로 영문 대소문자, 숫자, 기호, 33개 제어 문자를 정의한다. RFC 20(STD 80)으로 네트워크 교환 표준으로 채택되었다. |
| CR (Carriage Return) | ASCII 0x0D. 인쇄 위치를 줄 시작으로 되돌리는 제어 문자. Windows 줄바꿈(CR+LF)의 일부이자 HTTP/SMTP 헤더 줄바꿈의 구성 요소다. |
| LF (Line Feed) | ASCII 0x0A. 인쇄 위치를 다음 줄로 이동시키는 제어 문자. Unix/Linux의 기본 줄바꿈 문자이다. |
| NUL | ASCII 0x00. 모든 비트가 0인 문자. C 언어에서 문자열 종료자(\0)로 사용된다. 천공 테이프에서는 "구멍 없음" 상태를 의미했다. |
| ESC | ASCII 0x1B. 이스케이프 문자. 후속 바이트의 해석을 변경하는 접두 문자로, ANSI 이스케이프 시퀀스(ESC[)의 시작이다. |
| UTF-8 | Unicode 코드 포인트를 가변 길이(1~4바이트) 바이트 시퀀스로 인코딩하는 방식. ASCII의 0x00~0x7F를 1바이트로 그대로 보존하므로 ASCII와 상위 호환된다. |
| Code Point | 문자 집합에서 특정 문자에 할당된 번호. ASCII에서는 0~127, Unicode에서는 U+0000~U+10FFFF 범위다. |
| FE (Format Effector) | 출력 장치의 출력 위치를 제어하는 ASCII 제어 문자 범주. BS, HT, LF, VT, FF, CR이 해당한다. |
| CC (Communication Control) | 통신 세션의 흐름을 제어하는 ASCII 제어 문자 범주. SOH, STX, ETX, EOT, ENQ, ACK, DLE, NAK, SYN, ETB이 해당한다. |
| IS (Information Separator) | 데이터를 계층적으로 구분하기 위한 ASCII 제어 문자 범주. FS > GS > RS > US 순의 계층 관계를 가진다. |
| BOM (Byte Order Mark) | Unicode 텍스트의 바이트 순서를 표시하는 문자(U+FEFF). UTF-8에서는 0xEF 0xBB 0xBF로 인코딩되며, 파일 시작에 있으면 인코딩 식별에 사용되지만 불필요한 문제를 일으키는 경우가 많다. |
참고 자료
- RFC 20: ASCII format for Network Interchange — https://www.rfc-editor.org/rfc/rfc20
- RFC 3629: UTF-8, a transformation format of ISO 10646 — https://www.rfc-editor.org/rfc/rfc3629
- RFC 7230: HTTP/1.1 Message Syntax and Routing (§3.5 줄바꿈 관용성) — https://www.rfc-editor.org/rfc/rfc7230
- RFC 5321: SMTP (§2.3.8 줄바꿈 규칙) — https://www.rfc-editor.org/rfc/rfc5321
- RFC 7464: JSON Text Sequences (RS 문자 사용) — https://www.rfc-editor.org/rfc/rfc7464
- 관련 심화 문서: RFC_심화_UTF8_Unicode.md (예정)
PlantUML
PlantUML 적용 테스트
사용법 : 코드블럭 작성시 plantuml을 입력후 해당 문법으로 작성합니다.
주의
-
브라우저에서 WebAssembly 실행을 차단한 경우 특정 문법이 렌더링 되지 않습니다. Safari의 경우
file://에 대한 WebAssembly 실행이 기본적으로 차단되어있습니다. -
#차단시 경고 문구 [PlantUML] 이 브라우저는 로컬 파일에서 WebAssembly를 차단하여 그래프 레이아웃 다이어그램을 렌더링할 수 없습니다 -
pdf 내보내기에서도 지원예정 입니다. 렌더링 엔진 별도 적용 작업 진행중. 기존 mermaid 문법과 동시 처리시 메모리 점유율 테스트 중.
예제
Port In/Out
@startuml
[c]
node node {
port p1
port p2
port p3
file f1
}
c --> p1
c --> p2
c --> p3
p1 --> f1
p2 --> f1
@enduml
Timing Diagram
@startuml
header some header
footer some footer
title My title
caption This is caption
legend
The legend
end legend
robust "Web Browser" as WB
concise "Web User" as WU
@0
WU is Idle
WB is Idle
@100
WU is Waiting
WB is Processing
@300
WB is Waiting
@enduml
mermaid 혼합시 렌더링 테스트
flowchart TD
    S["XPath 쿼리<br/>pre > code.language-mermaid"] --> LOOP

    subgraph LOOP ["foreach block"]
        direction TB
        L1["다이어그램 소스 추출<br/>html_entity_decode(textContent)"]
        L2["임시 .mmd 파일 생성<br/>/tmp/mmd_in_xxx.mmd"]
        L3["mmdc 실행<br/>node cli.js -i input -o output.png -s 2"]
        L4["@unlink 입력 파일"]
        L5{"성공?<br/>exitCode===0<br/>filesize > 0"}
        L6["DOM에 img 삽입<br/>src=file:///tmp/xxx.png"]
        L7["mermaidTempFiles에<br/>경로 추가"]
        L8["@unlink 출력 파일"]

        L1 --> L2 --> L3 --> L4 --> L5
        L5 -- "성공" --> L6 --> L7
        L5 -- "실패" --> L8
    end

    style L3 fill:#f4845f,color:#fff
    style L6 fill:#5bc0de,color:#fff
Smoke test
   @startuml
   Alice -> Bob : [[javascript:alert(1) 클릭금지]]
   @enduml
변형 문법 테스트
@startsalt
skinparam dpi 200
{
<&person> Login | "MyName "
<&key> Password | "**** "
[<&circle-x> Cancel ] | [ <&account-login> OK ]
}
@endsalt
Cookbook
TOML v1.0.0. 쿡북
값 타입 , 구조 표현 , 실전 파일 패턴 기반 TOML 쿡북
읽은 결과와 오류 메시지는 Python 3.14.2 tomllib 실측. 날짜·시각은 Python 객체 표기.
- 1. 값 옆에 이유 적기
- 2. 여러 줄 텍스트
- 3. 경로·정규식·SQL — 백슬래시와 따옴표
- 4. 큰 수·권한·마스크·색상
- 5. 날짜·시각 고르기
- 6. 점·공백·유니코드가 든 키
- 7. 계층 — 헤더·dotted 키·인라인 테이블
- 8. 목록
- 9. 객체 목록
- 10. 루트 키와 섹션 순서
- 11. 섹션 나눠 쓰기 — 되는 것과 안 되는 것
- 12. 값 없음·선택 항목
- 13. JSON → TOML
- 14. 파일 한 장
- 참고
1. 값 옆에 이유 적기
#부터 줄 끝까지 주석. 전용 줄, 값 뒤 모두 가능. 파싱 결과에 남지 않는다.
# 프로젝트 설정 — 이 파일은 저장소에 커밋한다
title = "docs"        # 사이트 제목. 브라우저 탭에 나온다

# ---- 빌드 ----------------------------------------------
[build]
minify = true         # 배포 빌드에서만 켠다
{"title": "docs", "build": {"minify": true}}
- 정렬 공백·들여쓰기는 문법이 아니다. 자유롭게 맞춘다.
- 주석에 값을 되풀이하지 않는다(
# 10%). 값을 고칠 때 같이 안 고쳐진다. - 주석 처리로 키를 끄지 않는다. 파서에게는 없던 키와 같다.
enabled = false로 끈다(레시피 12).
2. 여러 줄 텍스트
"""...""". 여는 구분자 뒤 첫 줄바꿈은 버려지고, 닫는 구분자 앞 줄바꿈은 남는다. 줄 끝 \는 다음 비공백까지의 공백·줄바꿈을 지운다. 들여쓰기는 값에 그대로 들어간다.
banner = """
백업이 완료되었습니다.
보관 위치: /var/backups
"""
one_line = """\
    여러 줄로 나눠 적었지만 \
    실제 값은 한 줄이다.\
"""
indented = """
  들여쓴 줄
    더 들여쓴 줄
"""
{"banner": "백업이 완료되었습니다.\n보관 위치: /var/backups\n",
 "one_line": "여러 줄로 나눠 적었지만 실제 값은 한 줄이다.",
 "indented": "  들여쓴 줄\n    더 들여쓴 줄\n"}
- 마지막 줄바꿈이 싫으면
"""를 마지막 글자 바로 뒤에 붙인다. """안에서도\는 이스케이프다. 백슬래시가 있는 텍스트는'''(레시피 3).
3. 경로·정규식·SQL — 백슬래시와 따옴표
리터럴 문자열 '...' '''...'''은 이스케이프를 해석하지 않는다.
| 값 안에 있는 것 | 표기 |
|---|---|
| 백슬래시 (경로·정규식) | '...' |
| 작은따옴표 (SQL) | '''...''' — 연속 두 개까지 안에 둘 수 있다 |
| 작은따옴표 + 백슬래시, 한 줄 | "..." + 백슬래시만 \\ |
| 탭·줄바꿈을 글자로 | "..." + \t \n |
path  = 'C:\Users\name\file.txt'
regex = '\d{4}-\d{2}-\d{2}'
sql = '''
SELECT * FROM t WHERE name = 'a' AND note LIKE '%x%'
'''
both = "작은따옴표 ' 와 큰따옴표 \" 와 백슬래시 \\ 가 다 들어간 값"
quote_in_lit = '''it''s fine'''
{"path": "C:\\Users\\name\\file.txt", "regex": "\\d{4}-\\d{2}-\\d{2}",
 "sql": "SELECT * FROM t WHERE name = 'a' AND note LIKE '%x%'\n",
 "both": "작은따옴표 ' 와 큰따옴표 \" 와 백슬래시 \\ 가 다 들어간 값",
 "quote_in_lit": "it''s fine"}
(JSON 출력의 \\는 값 안에서 백슬래시 한 개.)
기본 문자열 이스케이프는 \b \t \n \f \r \" \\ \uXXXX \UXXXXXXXX 아홉 개. "caf\u00E9 \U0001F600" → café 😀.
# × 한 줄 리터럴 안의 작은따옴표 — 거기서 닫힌다
x = 'can't'
Expected newline or end of document after a statement (at line 1, column 10)
# × 기본 문자열의 Windows 경로 — \U 가 유니코드 이스케이프
path = "C:\Users\name"
Invalid hex value (at line 1, column 13)
path = "C:\temp\new" # 오류 없음. \t 는 탭, \n 은 줄바꿈이 된다
{"path": "C:\temp\new"}
세 번째는 파싱이 성공하므로 가장 늦게 발견된다. 경로는 항상 '...'.
4. 큰 수·권한·마스크·색상
자릿수 구분 _, 진법 접두 0x 0o 0b. 읽으면 전부 정수. 파서는 진법을 기억하지 않는다.
bytes  = 10_485_760      # 10 MiB
mode   = 0o755           # 파일 권한
mask   = 0b1111_0000     # 상위 4비트
color  = 0xFF_88_00      # RGB
ratio  = 0.25
avogad = 6.022e23
limit  = inf
undef  = nan
{"bytes": 10485760, "mode": 493, "mask": 240, "color": 16746496,
 "ratio": 0.25, "avogad": 6.022e+23, "limit": Infinity, "undef": NaN}
# × 리딩 제로
port = 007
# × 소수점 한쪽이 비어 있음
r = .5
# × 진법 접두에 부호
m = -0xFF
port: Expected newline or end of document after a statement (at line 1, column 9)
r:    Invalid value (at line 1, column 5)
m:    Expected newline or end of document after a statement (at line 1, column 7)
- 정수 범위는 64비트(−2⁶³ ~ 2⁶³−1).
9223372036854775808을tomllib은 읽지만(Python 정수가 임의 정밀도) 스펙 밖이다. 64비트 언어에서는 오류 또는 잘림. 그 크기는 문자열로. - 실수는 binary64. 금액은 정수(최소 단위) 또는 문자열.
5. 날짜·시각 고르기
따옴표 없이 쓴다. 기준: 어디서 읽어도 같은 순간이면 오프셋, 그 자리의 벽시계면 Local.
| 값의 뜻 | 종류 | 예 |
|---|---|---|
| 같은 순간 (배포 시각, 만료 시점) | Offset Date-Time | 2026-10-01T00:00:00+09:00, ...Z |
| 반복되는 벽시계 시각 (점검 시작) | Local Time | 03:30:00 |
| 하루 단위 (기한) | Local Date | 2026-10-01 |
| 벽시계 날짜+시각, 시간대는 다른 키 | Local Date-Time | 2026-10-01T09:00:00 + timezone = "Asia/Seoul" |
released   = 2026-10-01T00:00:00+09:00
built      = 2026-10-01T00:00:00Z
local_dt   = 2026-10-01T09:00:00
launch_day = 2026-10-01
daily_at   = 03:30:00
space_sep  = 2026-10-01 09:00:00         # T 대신 공백
| 키 | 읽은 값 |
|---|---|
released |
datetime(2026, 10, 1, 0, 0, tzinfo=+09:00) |
built |
datetime(2026, 10, 1, 0, 0, tzinfo=UTC) |
local_dt, space_sep |
datetime(2026, 10, 1, 9, 0) — tzinfo 없음 |
launch_day |
date(2026, 10, 1) |
daily_at |
time(3, 30) |
"2026-10-01"은 문자열.{"d": "2026-10-01"}로 읽히고 날짜 연산이 안 된다.- Local Date-Time은 시간대 해석이 읽는 쪽 몫이라 언어마다 갈린다(6편 레시피 3). 절대 시점은 오프셋을 붙인다.
6. 점·공백·유니코드가 든 키
bare 키는 A-Z a-z 0-9 _ -. 그 밖은 따옴표. 키는 항상 문자열이고 대소문자를 구분한다.
name = "bare"
ko-KR = "하이픈은 bare 키에 허용"
"ko KR" = "공백은 따옴표"
"api.example.com" = "점은 따옴표 없으면 경로"
'1.2' = "버전 문자열 키"
1234 = "숫자만 있는 키도 문자열 키"
"" = "빈 키도 허용되지만 쓰지 않는다"
{"name": "bare", "ko-KR": "하이픈은 bare 키에 허용", "ko KR": "공백은 따옴표",
 "api.example.com": "점은 따옴표 없으면 경로", "1.2": "버전 문자열 키",
 "1234": "숫자만 있는 키도 문자열 키", "": "빈 키도 허용되지만 쓰지 않는다"}
1.2 = "x" # 오류 없음. 키 "1.2"가 아니라 경로
{"1": {"2": "x"}}
호스트명·버전·IP·패키지명은 따옴표 필수. 오류가 아니라 트리 모양이 바뀌므로 늦게 발견된다.
# × 같은 키 두 번
name = 1
name = 2
Cannot overwrite a value (at end of document)
7. 계층 — 헤더·dotted 키·인라인 테이블
세 표기의 결과는 같다.
# A. 테이블 헤더
[server]
host = "localhost"
port = 8080

[server.tls]
enabled = true
cert = "/etc/ssl/server.pem"
# B. dotted 키
server.host = "localhost"
server.port = 8080
server.tls.enabled = true
server.tls.cert = "/etc/ssl/server.pem"
# C. 인라인 테이블
server = { host = "localhost", port = 8080, tls = { enabled = true, cert = "/etc/ssl/server.pem" } }
{"server": {"host": "localhost", "port": 8080, "tls": {"enabled": true, "cert": "/etc/ssl/server.pem"}}}
| 상황 | 표기 |
|---|---|
| 키가 많다, 값마다 주석 | A 헤더 |
| 키 한두 개, 얕은 중첩 | B dotted 키 |
| 키 서너 개, 한 줄에 | C 인라인 |
| 3단 이상 중첩 | A 헤더 |
- 인라인 테이블은 v1.0.0에서 한 줄, 후행 콤마 불가, 정의 후 키 추가 불가(레시피 11). 커질 것은 처음부터 헤더.
- 헤더 아래의 dotted 키는 그 헤더의 하위.
[server]아래tls.enabled = true는server.tls.enabled.
8. 목록
배열 [ ]. v1.0.0에서도 여러 줄·후행 콤마·원소 옆 주석 가능.
origins = [
  "https://app.example.com",
  "https://admin.example.com",   # 관리 콘솔
]
ports   = [8080, 8081, 8082]
matrix  = [[1, 0], [0, 1]]
mixed   = [1, "two", 3.0, true, 2026-10-01]
empty   = []
nested_objs = [
  { name = "a", weight = 1 },
  { name = "b", weight = 3 },
]
{"origins": ["https://app.example.com", "https://admin.example.com"],
 "ports": [8080, 8081, 8082], "matrix": [[1, 0], [0, 1]],
 "mixed": [1, "two", 3.0, true, datetime.date(2026, 10, 1)],
 "empty": [], "nested_objs": [{"name": "a", "weight": 1}, {"name": "b", "weight": 3}]}
- 원소마다 줄바꿈 + 후행 콤마: 추가·삭제 diff가 한 줄.
- 타입 혼합은 허용되지만 설정에서는 한 배열 한 타입.
- 배열은 통째로 한 값. 나중에 덧붙이는 문법이 없고, 파일 겹쳐 읽기에서도 병합이 아니라 교체(6편 레시피 4). "기본 + 추가"는 키를 둘로.
- 인라인 테이블 배열(
nested_objs)은 원소가 두세 키일 때. 커지면 레시피 9.
9. 객체 목록
같은 꼴 객체의 반복. 헤더마다 원소 하나. 뒤따르는 [name.sub]은 직전 원소에 붙는다.
[[menu]]
name = "홈"
url  = "/"

[[menu]]
name = "문서"
url  = "/docs"

[menu.badge]          # 직전 원소(문서)에 붙는다
text = "new"

[[menu]]
name = "블로그"
url  = "/blog"
{"menu": [{"name": "홈", "url": "/"},
          {"name": "문서", "url": "/docs", "badge": {"text": "new"}},
          {"name": "블로그", "url": "/blog"}]}
부착 대상은 이름이 아니라 위치. [menu.badge]를 세 번째 [[menu]] 뒤로 옮기면 블로그에 붙는다.
| 상황 | 표기 |
|---|---|
| 원소마다 키 서너 개 이상, 원소별 주석 | [[menu]] |
| 원소가 한두 키, 전체가 한눈에 | menu = [{ ... }, { ... }] |
| 원소에 하위 테이블 | [[menu]] + [menu.sub] |
한 목록은 한 표기로. 대괄호 하나와 둘은 섞이지 않는다.
# × 테이블을 배열로 이어 쓰기
[server]
host = "a"
[[server]]
host = "b"
Cannot overwrite a value (at line 3, column 9)
# × 배열을 테이블로 이어 쓰기
[[a]]
x = 1
[a]
y = 2
Cannot declare ('a',) twice (at line 3, column 3)
# × 인라인 배열에 [[ ]]로 덧붙이기
products = [{ name = "a" }]
[[products]]
name = "b"
Cannot mutate immutable namespace ('products',) (at line 2, column 11)
10. 루트 키와 섹션 순서
헤더 없이 시작하는 키는 루트. 첫 헤더 뒤의 키는 전부 그 헤더 아래. 루트로 돌아오는 문법은 없다.
[server]
port = 8080
app_name = "orders"    # server 아래로 들어간다
{"server": {"port": 8080, "app_name": "orders"}}
app_name = "orders"
version  = "1.4.0"

[server]
port = 8080
{"app_name": "orders", "version": "1.4.0", "server": {"port": 8080}}
- 파일 전체의 메타 키(이름·버전·설명)는 첫 헤더 앞에.
- 섹션 순서는 파서에 의미 없음. 예외는
[[ ]]부착(레시피 9). - 헤더는 매번 루트 기준 절대 경로.
[a.b]뒤에[c]로 얕아져도 된다.
11. 섹션 나눠 쓰기 — 되는 것과 안 되는 것
기준: 그 테이블이 이미 명시적으로 정의되었는가.
| 먼저 쓴 것 | 나중에 |
|---|---|
[a.b] (상위 a는 암묵 생성) |
[a] 가능 |
[a] |
[a] 불가, [a.c] 가능 |
[a] 안의 b.c = 1 |
[a.b] 불가 |
a = { ... } |
a.x = 1, [a], [a.x] 불가 |
a = [{ ... }] |
[[a]] 불가 (레시피 9) |
[a.b]
x = 1

[a]
y = 2
{"a": {"b": {"x": 1}, "y": 2}}
# × 같은 헤더 두 번
[a]
x = 1

[a]
y = 2
Cannot declare ('a',) twice (at line 4, column 3)
# × dotted 키로 만든 테이블을 헤더로 다시 열기
[a]
b.c = 1

[a.b]
d = 2
Cannot declare ('a', 'b') twice (at line 4, column 5)
# × 인라인 테이블에 밖에서 키 추가
point = { x = 1 }
point.y = 2
Cannot mutate immutable namespace ('point',) (at line 2, column 12)
허용되는 경우라도 같은 테이블의 키는 한 곳에 모은다.
12. 값 없음·선택 항목
null이 없다. "설정 안 함"은 키를 뺀다. "비움"은 [] "". "끔"은 false.
| 상태 | TOML | 읽는 쪽 |
|---|---|---|
| 설정하지 않음 (기본값) | 키 없음 | 부재 → 기본값 |
| 명시적으로 비움 | [], "" |
빈 값 |
| 기능 끔 | enabled = false |
불리언 |
| 끄되 기한을 남김 | enabled = false + disabled_until = 2026-10-15 |
날짜 비교 |
[proxy]
# url 키를 생략하면 프록시를 쓰지 않는다
timeout_sec = 5

[report]
recipients = []          # 빈 배열: 받는 사람 없음
subject = ""             # 빈 문자열: 제목 없음
{"proxy": {"timeout_sec": 5}, "report": {"recipients": [], "subject": ""}}
# × null 리터럴
x = null
Invalid value (at line 1, column 5)
"키 없음"과 "빈 값"의 뜻을 파일 주석과 읽는 코드가 같게 둔다.
13. JSON → TOML
| JSON | TOML | 레시피 |
|---|---|---|
| 스칼라 | 그대로 | 3, 4 |
null |
키 삭제 | 12 |
| 날짜처럼 생긴 문자열 | 따옴표 유지. 날짜 타입은 읽는 코드가 기대할 때만 | 5 |
| 작은 객체 | 인라인 테이블 | 7 |
| 큰 객체 | [a.b] 헤더 |
7 |
| 원시 값 배열 | 배열 | 8 |
| 객체 배열 | [[a]] |
9 |
| 최상위 스칼라 | 첫 헤더 앞 | 10 |
| 점·공백 든 키 | 따옴표 키 | 6 |
{
  "name": "widget",
  "tags": ["a", "b"],
  "price": 9.5,
  "in_stock": true,
  "discount": null,
  "released": "2026-10-01",
  "dims": { "w": 10, "h": 20 },
  "variants": [
    { "sku": "W-1" },
    { "sku": "W-2", "color": "red" }
  ]
}
name     = "widget"
tags     = ["a", "b"]
price    = 9.5
in_stock = true
# discount: null은 TOML에 없다. 키를 뺀다
released = "2026-10-01"     # 원본이 문자열이면 따옴표 유지
dims     = { w = 10, h = 20 }

[[variants]]
sku = "W-1"

[[variants]]
sku   = "W-2"
color = "red"
두 파일의 파싱 결과는 null 키를 뺀 원본 기준 동일(True). released는 양쪽 다 문자열.
변환 도구 출력에는 주석이 없다. 옮긴 뒤 레시피 1.
14. 파일 한 장
레시피 조합 예. 로컬 백업 도구 설정. 주석의 번호는 레시피.
# backup.toml — 로컬 백업 도구 설정                         (1)
name    = "laptop-backup"                                  # 루트 키는 첫 헤더 앞 (10)
version = "2"                       # 도구가 문자열로 비교. 숫자로 승격하지 않음 (13)

[schedule]
daily_at     = 02:30:00             # 반복 시각 = Local Time (5)
weekly_on    = "sun"
paused_until = 2026-10-15           # 기한 = Local Date. 키를 지우면 재개 (5, 12)

[retention]
daily   = 7
weekly  = 4
monthly = 12
min_free_bytes = 5_368_709_120      # 5 GiB (4)

[storage]
root = '/Volumes/Backup'            # 경로 = 리터럴 (3)
mode = 0o700                        # 권한 = 8진 (4)

[storage.remote]                    # 키가 늘 수 있는 하위 객체 = 헤더 (7)
bucket = "laptop-backup"
region = "ap-northeast-2"

[[targets]]                         # 반복 객체 (9)
name    = "documents"
path    = '~/Documents'
exclude = ['\.DS_Store$', '/node_modules/', '\.tmp$']   # 정규식 = 리터럴 (3)

[[targets]]
name     = "photos"
path     = '~/Pictures'
compress = false                    # 끔 = false (12)

[targets.limits]                    # 직전 원소(photos)에만 (9)
max_file_bytes = 4_294_967_296

[notify]
on_failure = { channel = "mail", to = ["me@example.com"] }   # 작은 객체 = 인라인 (7, 8)
on_success = { channel = "none" }
targets[1] = {"name": "photos", "path": "~/Pictures", "compress": false,
              "limits": {"max_file_bytes": 4294967296}}
storage.mode = 448 (0o700)
schedule.daily_at = datetime.time(2, 30)
섹션 순서는 메타 → 동작 → 저장 위치 → 대상 → 알림. 파서에 의미 있는 순서는 [[targets]]와 [targets.limits]의 상대 위치뿐.
참고
- TOML v1.0.0 스펙 · v1.1.0 — 1.1 변경점은 1편 §6
- Python tomllib — 실측 파서